
So funktioniert es
Ein Projekt, von der ersten Frage bis zu einer belastbaren Antwort.
Fünf Phasen, ein Forschungsbericht. Jede Phase unten beginnt mit dem, was sie leistet; die Details sind einen Klick entfernt, wenn Sie sie brauchen.
Armiger
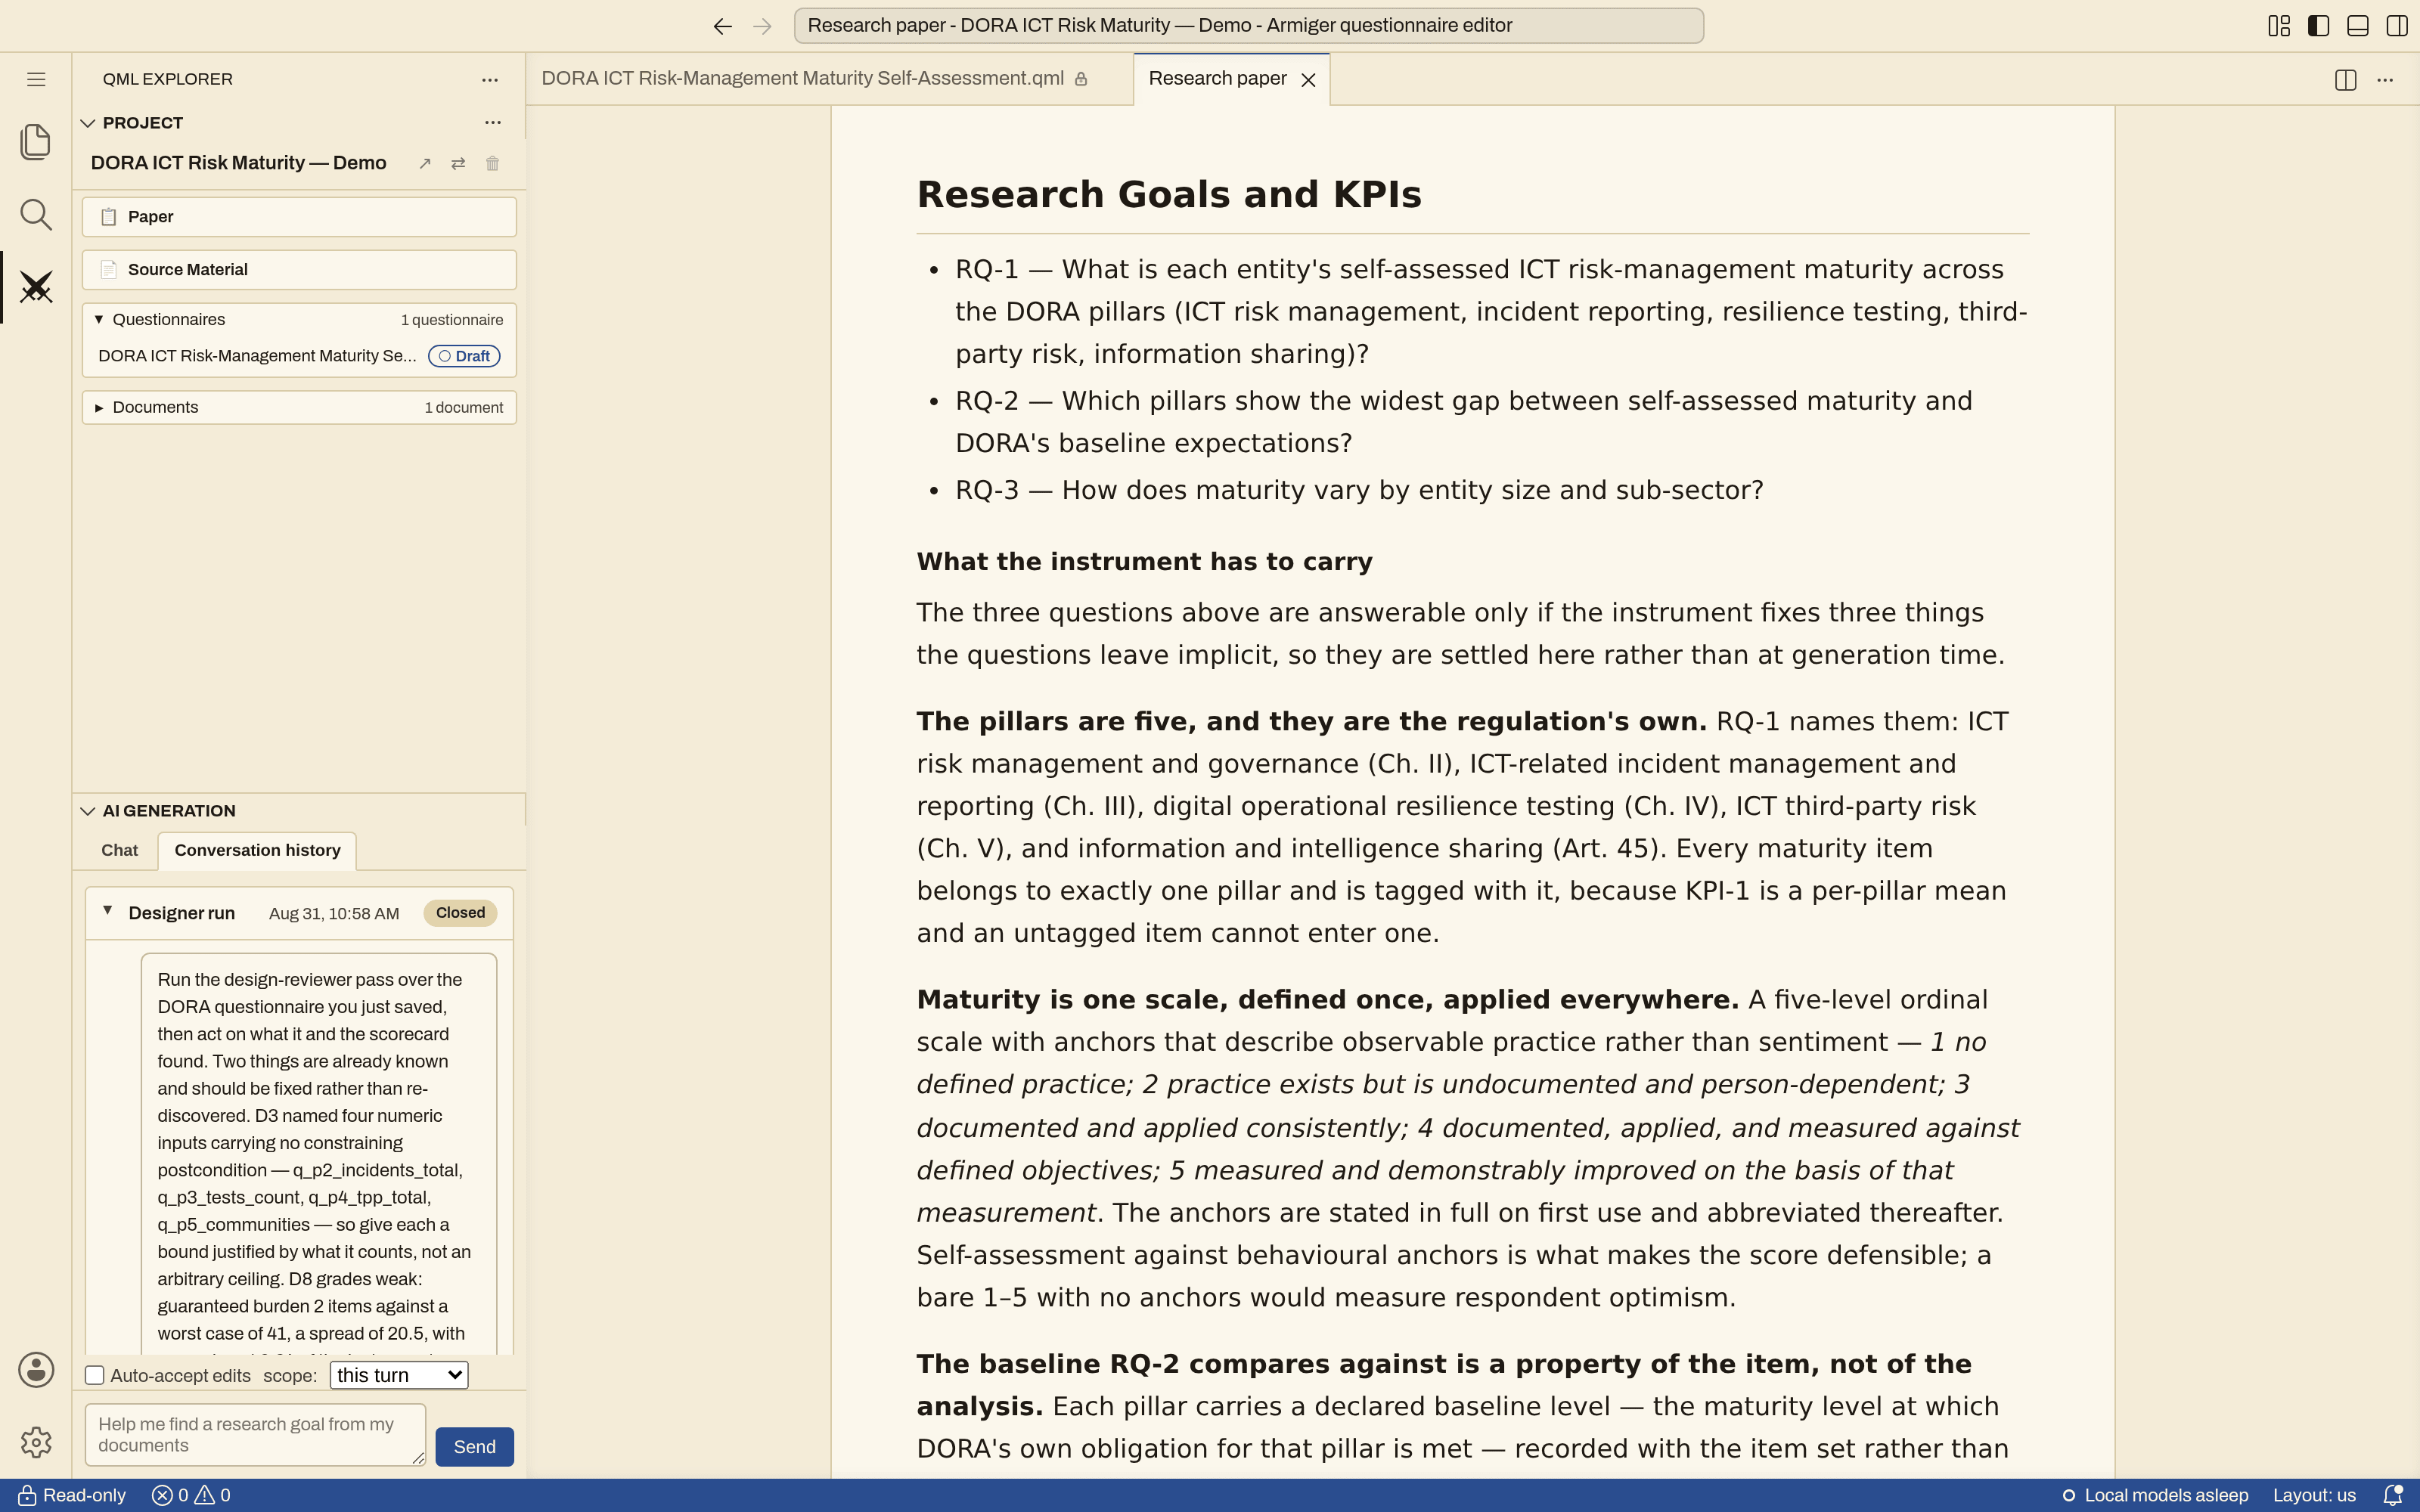
Am Anfang steht eine Idee — und die Dokumente, die Sie bereits haben.
Laden Sie hoch, was Sie haben: Fachartikel, Verordnungen, klinische Leitlinien, Grundsatzdokumente, frühere Studien. Der Agent Research Assistant indexiert sie und erarbeitet mit Ihnen das Forschungsziel, was gemessen werden soll, wen Sie befragen und in welchem Format — alles festgehalten im Forschungsbericht des Projekts, dem einen Dokument, das jede spätere Phase weiter ergänzt.
- Dokumentenaufnahme — PDF, Word, Tabellen und reiner Text, indexiert für die Suche auch in großen Beständen
- Gemeinsame Eingrenzung — der Agent schlägt Ziele, messbare Konstrukte, Kennzahlen, Zielgruppe und Format vor; Sie steuern und geben frei
- Der Forschungsbericht — von Agenten geschrieben, von Menschen gelesen, druckbar und als veraltet markiert, wenn die Daten unter einer Schlussfolgerung neu berechnet werden
Weitere Details
Indexierte Dokumente gehören zum jeweiligen Projekt, sodass die Quellen eines Teams nie die Fragen eines anderen Teams beantworten. Derselbe Ablauf dient sehr unterschiedlichen Arten von Forschung:
Der Forschungsbericht hat ein Kapitel pro Phase: Der Designer schreibt die Ziele und das Instrument, der Manager die Grundgesamtheit und die Erhebung, der Analyst die Studien und die Qualitätsbewertung. Was ein Forschungsbericht ist (Englisch)
Armiger
Vom Forschungsziel zum verifizierten Fragebogen.
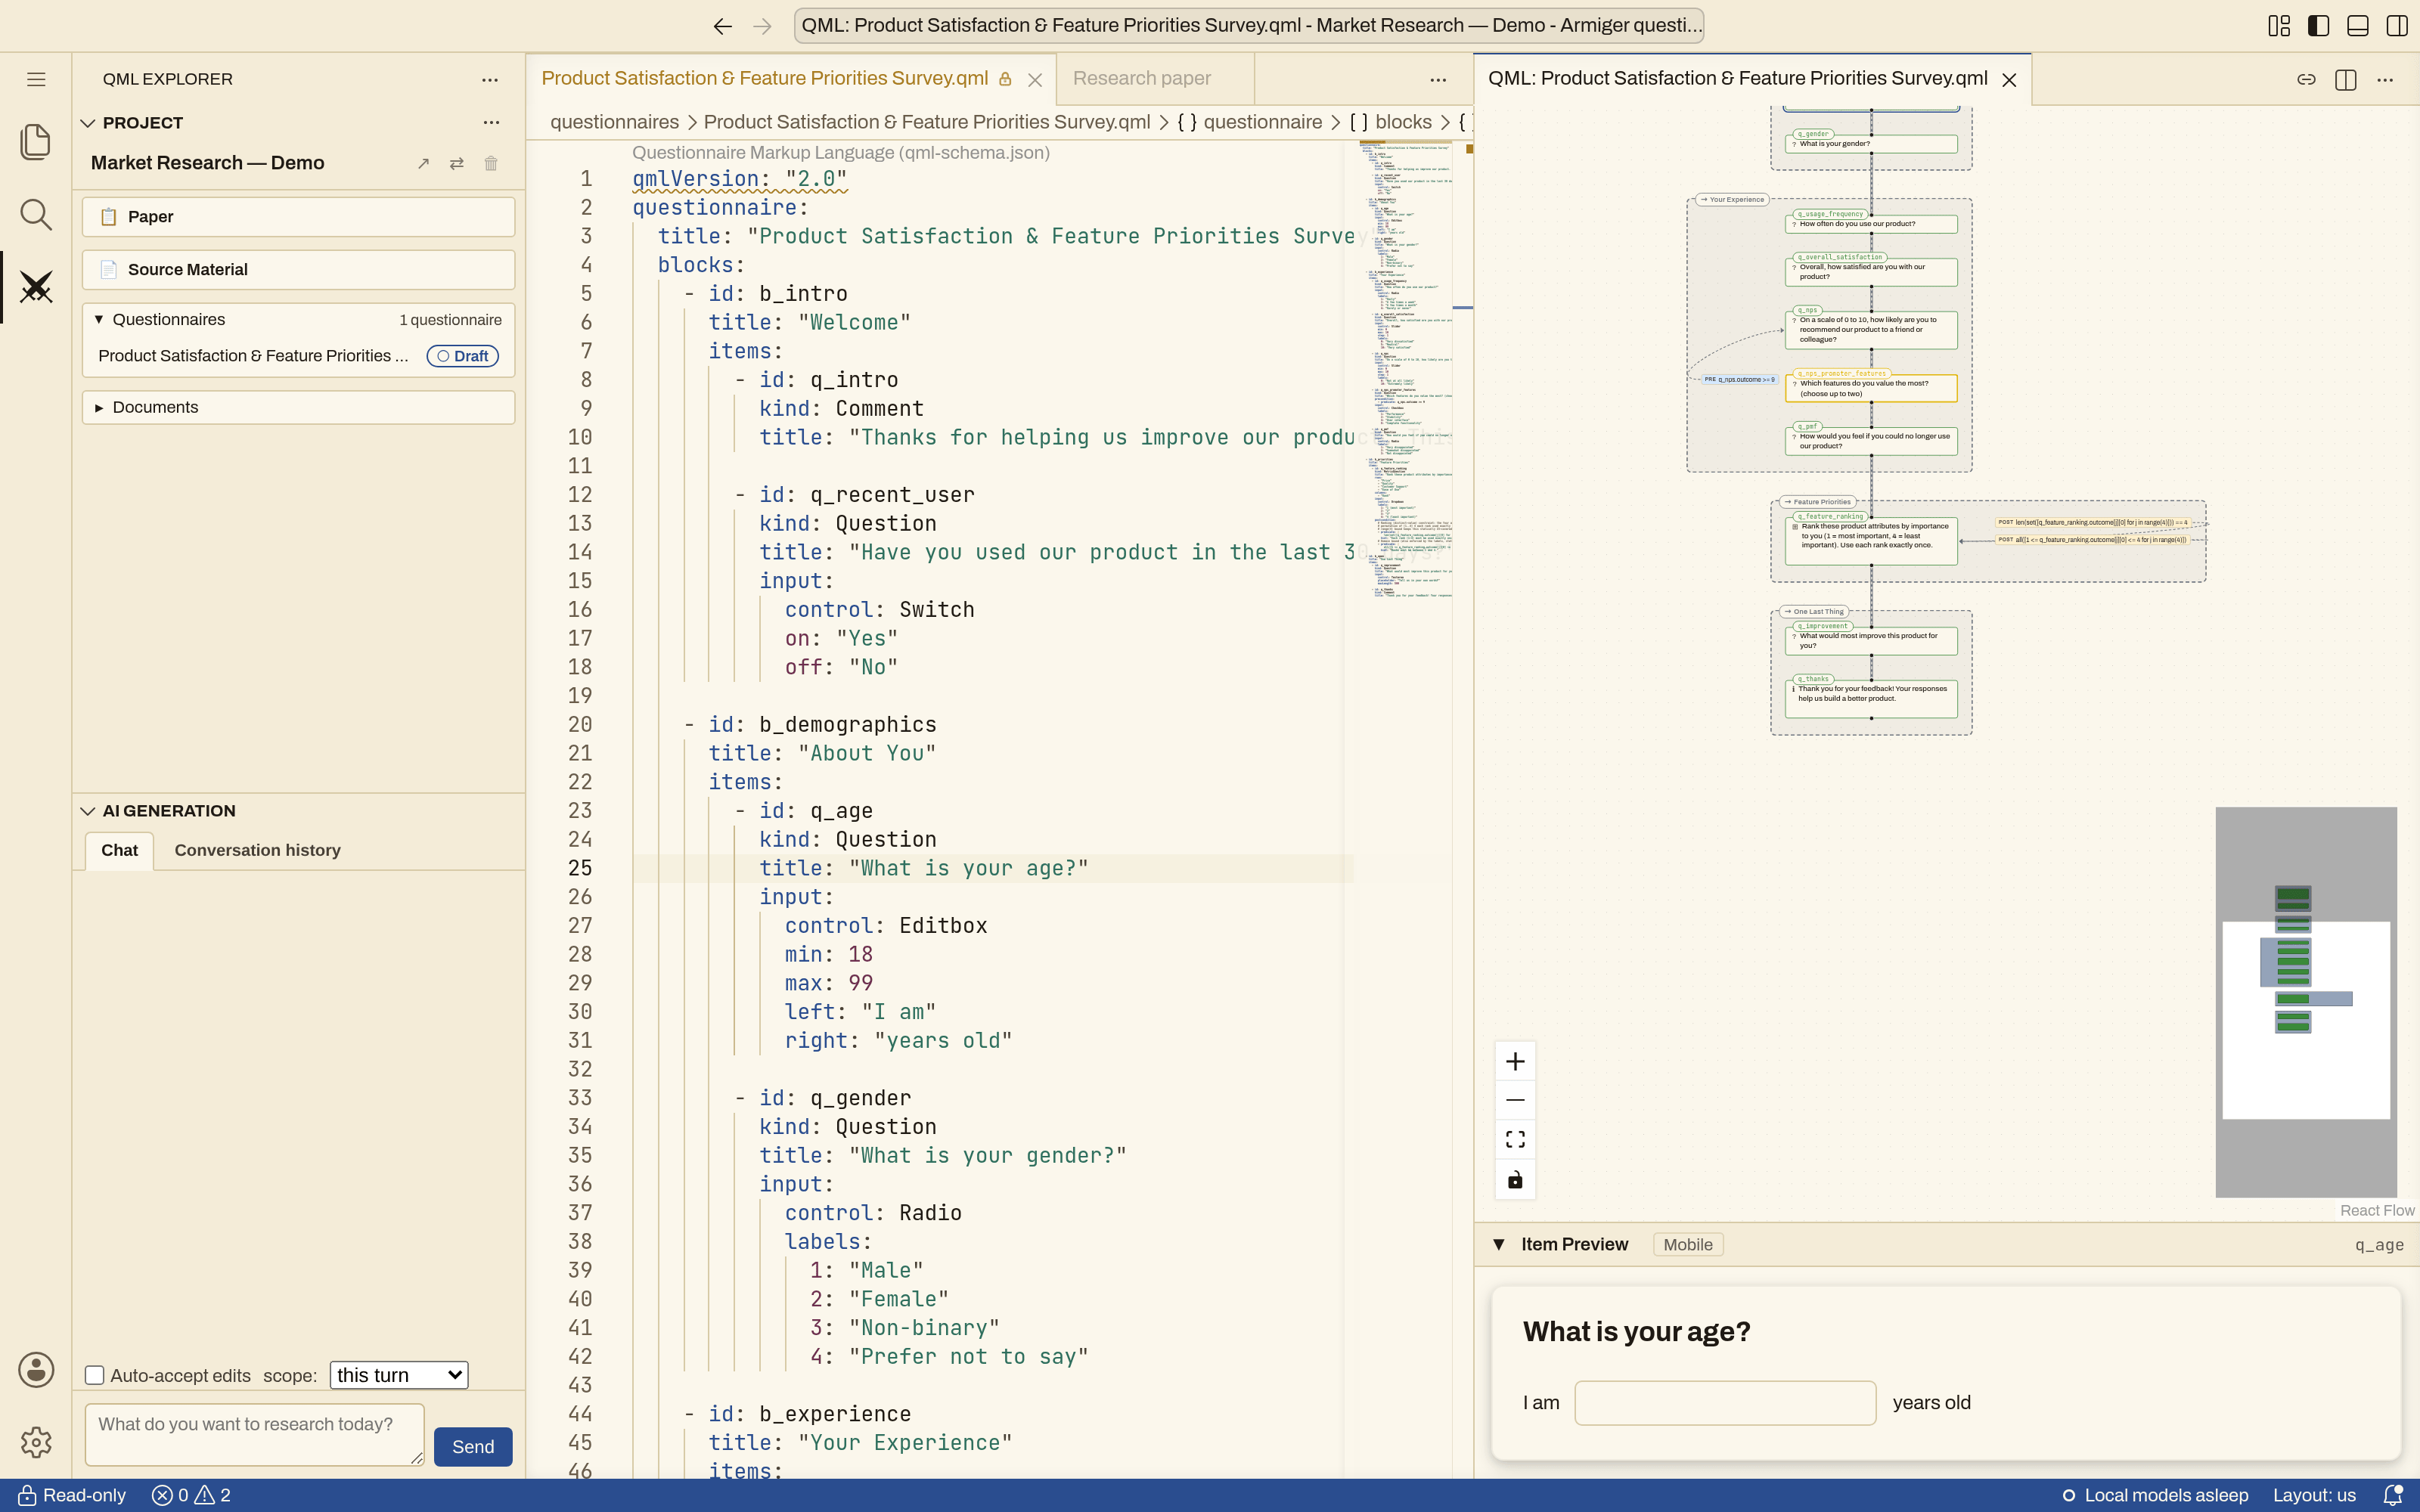
Sobald die Ziele im Forschungsbericht stehen, schreiben Sie oder der Designer-Agent den Fragebogen in QML: Jede Frage legt fest, wann sie relevant ist, und der Compiler leitet den Ablauf ab. Der SMT-Solver prüft dann jeden Antwortpfad auf unerreichbare Fragen, unerfüllbare Bedingungen und zirkuläre Abhängigkeiten, und der Agent wiederholt Entwurf → Prüfung → Korrektur, bis der Fragebogen besteht.
- Bedingungen und Antwortprüfungen sind Ausdrücke über frühere Antworten — zählen, addieren, multiplizieren, vergleichen — und werden wie alle anderen verifiziert
- KI entwirft QML aus natürlicher Sprache oder aus den indexierten Dokumenten
- Ein Browser-Editor mit dem Ablaufdiagramm und einer Live-Vorschau jeder Frage
- Ein Fragebogen kann erst ins Feld gehen, wenn er die Verifikation besteht
Logik, die andere Umfragetools kaum ausdrücken können
Mehrere Antworten in einem Ausdruck. Die meisten Umfragetools vergleichen eine Antwort mit einem festen Wert; eine QML-Bedingung kann so viele Antworten kombinieren, wie die Regel braucht. Und diese müssen nicht zuerst in der Datei stehen: Die Engine baut aus jeder Bedingung einen Abhängigkeitsgraphen und stellt jede Frage erst, nachdem alles beantwortet ist, wovon sie abhängt, sodass die Frage unten auch über ihren vier Eingaben stehen könnte. Ein echter Zyklus — A hängt von B ab und B von A — wird abgelehnt, mit Nennung der Items.
precondition:
  - predicate: "q1.outcome + q4.outcome > q7.outcome * q6.outcome"
Mitzählen. Jede Aussage zählt ihr „Stimme nicht zu“ zu einem Zähler hinzu; nach drei fragt ein Folgeblock nach dem Grund.
codeInit: |
  negatives = 0
# on each statement
codeBlock: |
  if q1.outcome == 3:
      negatives = negatives + 1
# on the follow-up block
precondition:
  - predicate: "negatives >= 3"
Antworten, die zueinander passen müssen. Niemand fährt länger Auto, als er einen Führerschein besitzen konnte, und ein Tag hat immer noch 24 Stunden:
postcondition:   # on q_drive
  - predicate: "q_drive.outcome <= q_age.outcome - 17"
    hint: "That is longer than you could have held a licence"
postcondition:   # on q_commute
  - predicate: "q_sleep.outcome + q_work.outcome + q_commute.outcome <= 24"
Teilnahmeregeln mit echter Arithmetik. Fragen zur Lungenkrebs-Früherkennung nur für Personen im Alter von 50–80 Jahren mit mindestens 20 Packungsjahren (Packungen pro Tag × Raucherjahre):
precondition:
  - predicate: "q_age.outcome >= 50 and q_age.outcome <= 80
                and q_cigs.outcome * q_years.outcome >= 400"
Jede wird wie jede andere Bedingung geprüft. Machen Sie eine davon unerfüllbar — Antwortbereiche, in denen Q1 + Q4 nie größer als Q7 × Q6 sein kann, ein Altersbereich, der keinen Raum für die Fahrjahre lässt, Mindestwerte, die zusammen mehr als 24 Stunden ergeben, zu wenige Zigaretten, um je 20 Packungsjahre zu erreichen — und der Fragebogen wird abgelehnt, bevor ihn jemand beantwortet.
Was die Verifikation ablehnt und wovor sie nur warnt
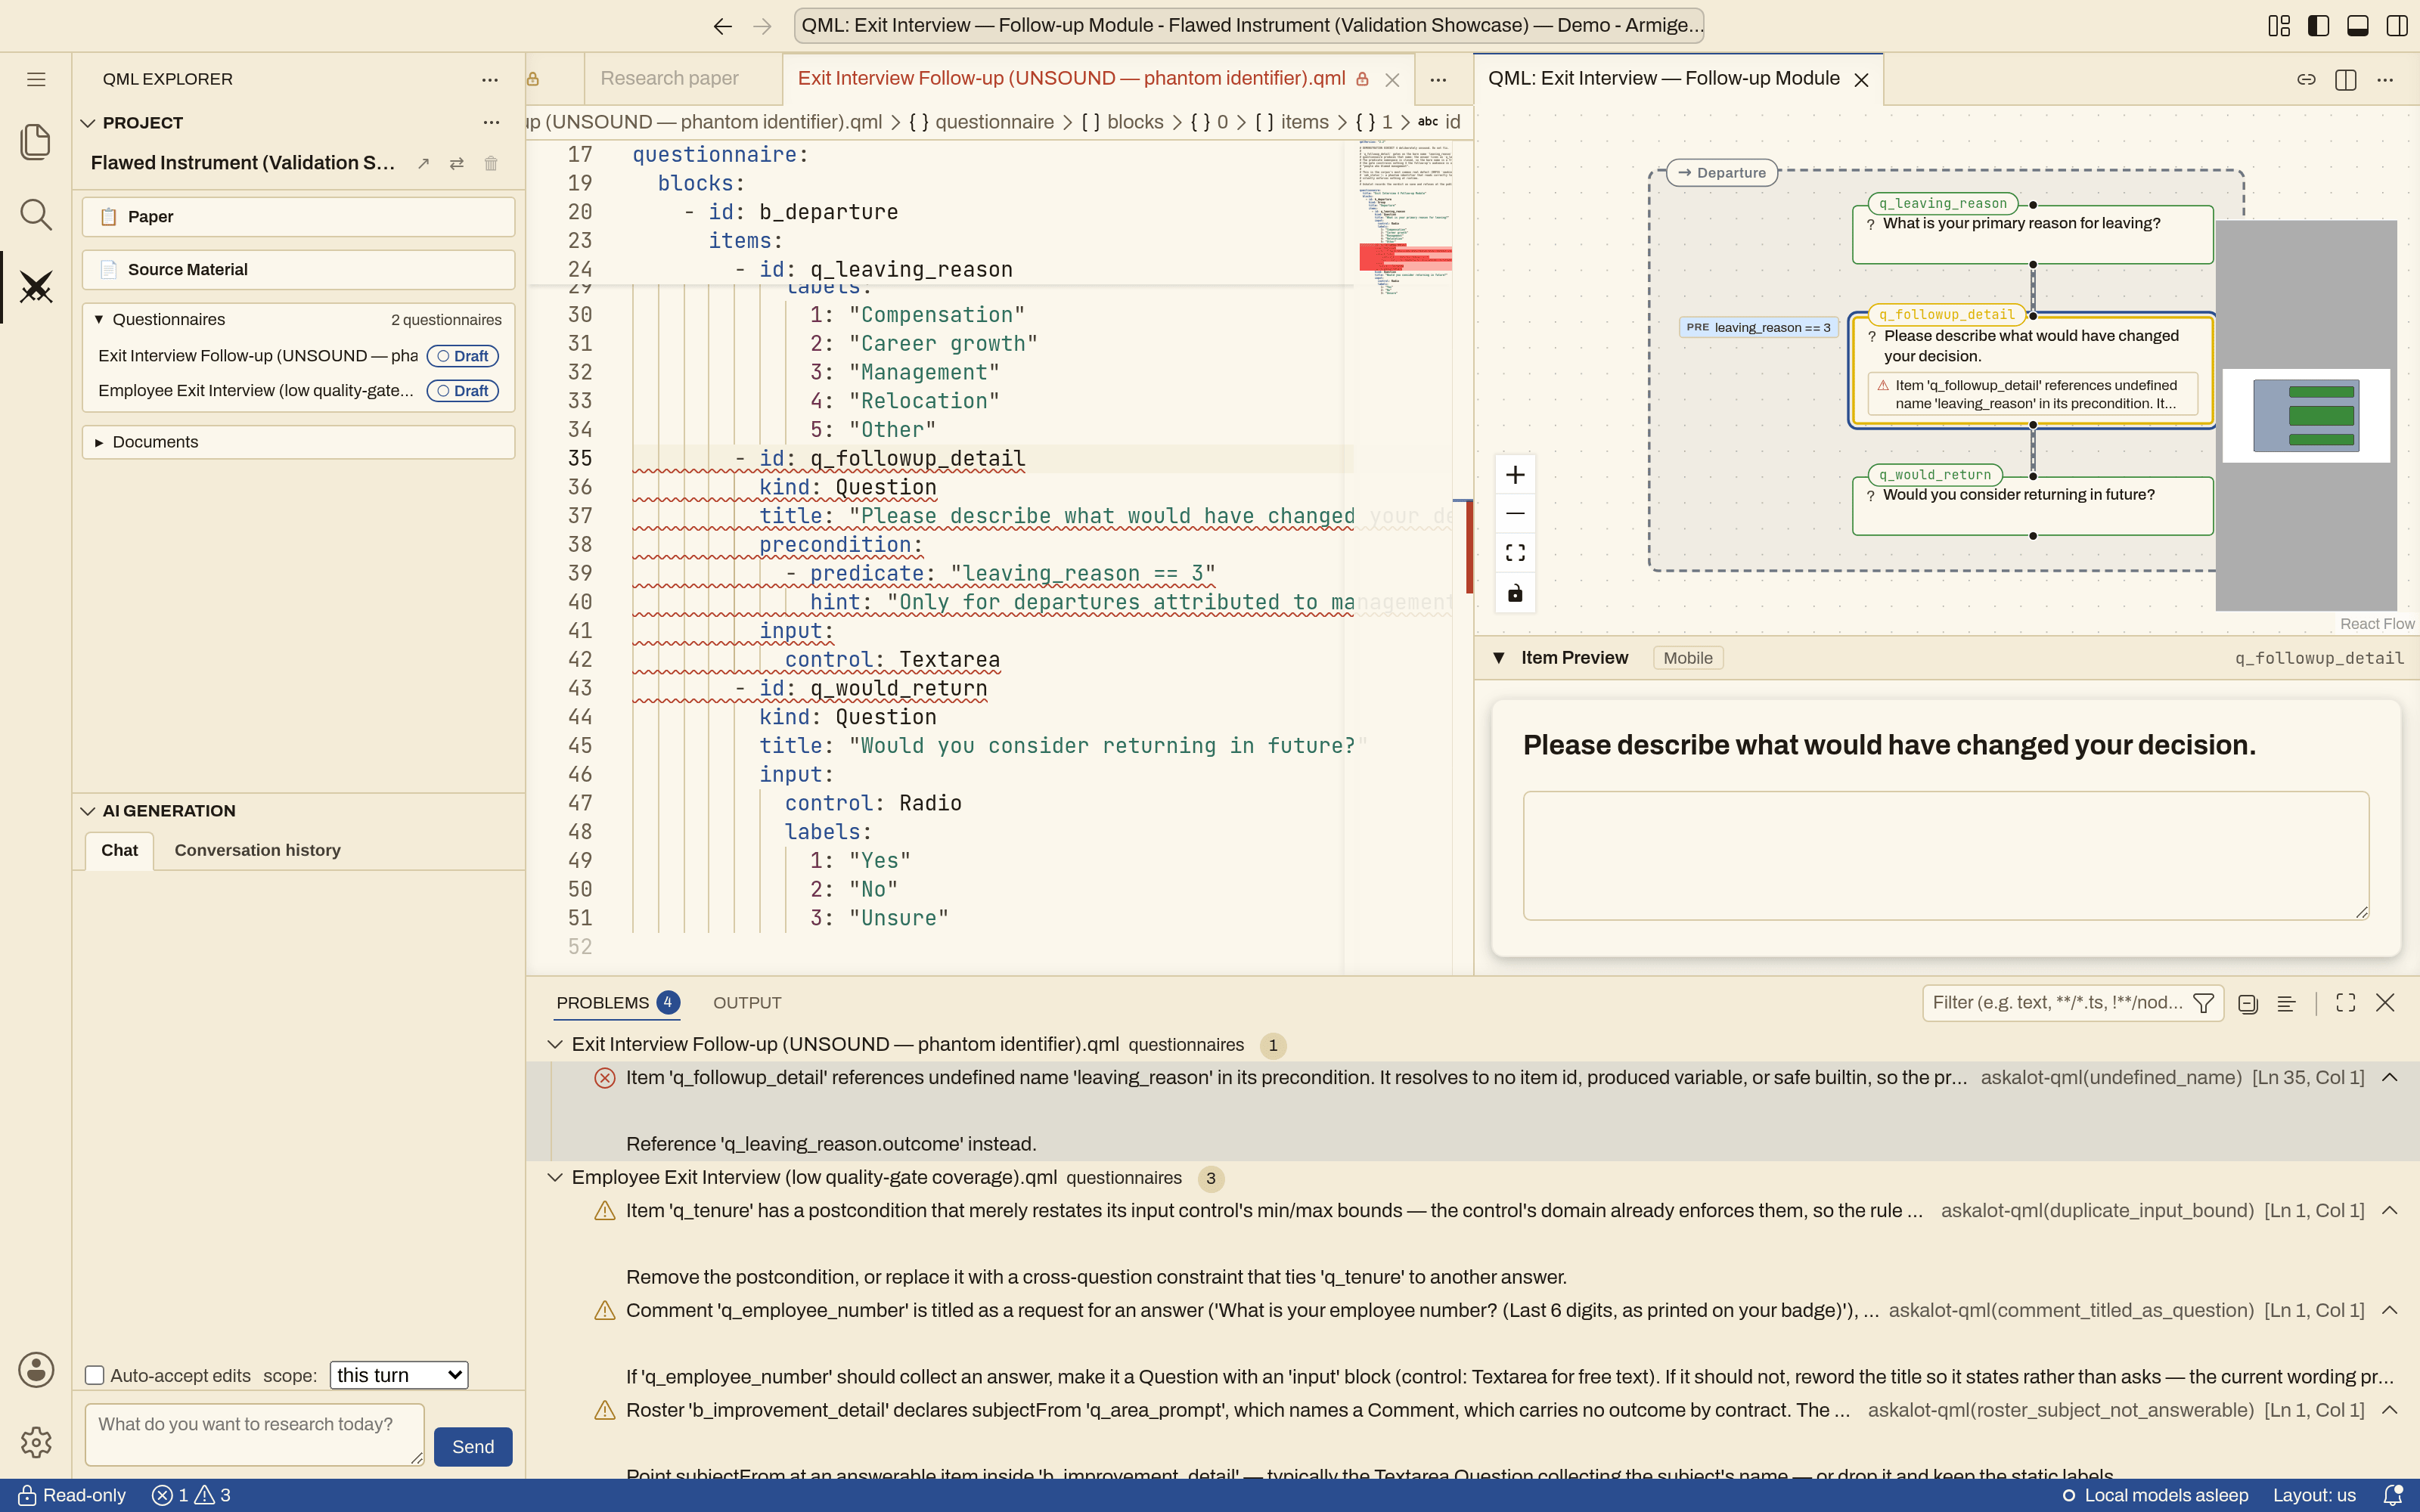
Bei der Veröffentlichung abgelehnt: eine Frage, die keine Antwort erreichen kann, eine Antwortprüfung, die keine Antwort erfüllen kann, eine Bedingung, die eine Antwort nennt, die keine Frage erzeugt, eine zirkuläre Abhängigkeit und Inhalte, die sich nicht laden lassen.
Als Warnung angezeigt: toter Code, der sich nur entlang eines Pfades ansammelt, Hygienebefunde (eine Variable, die geschrieben und nie gelesen wird, eine doppelte Schranke) und Bedingungen außerhalb dessen, was der Solver entscheiden kann; diese werden als Abdeckungslücken gemeldet, statt als bewiesen zu gelten.
Alles wird gegen das formale Modell des Fragebogens geprüft, auf drei Arten: jedes Item für sich, der gesamte Fragebogen auf einmal und entlang jedes Pfades. Die Validierungshierarchie (Englisch)
Targetor
Die richtige Zielgruppe erreichen. In Wellen erheben.
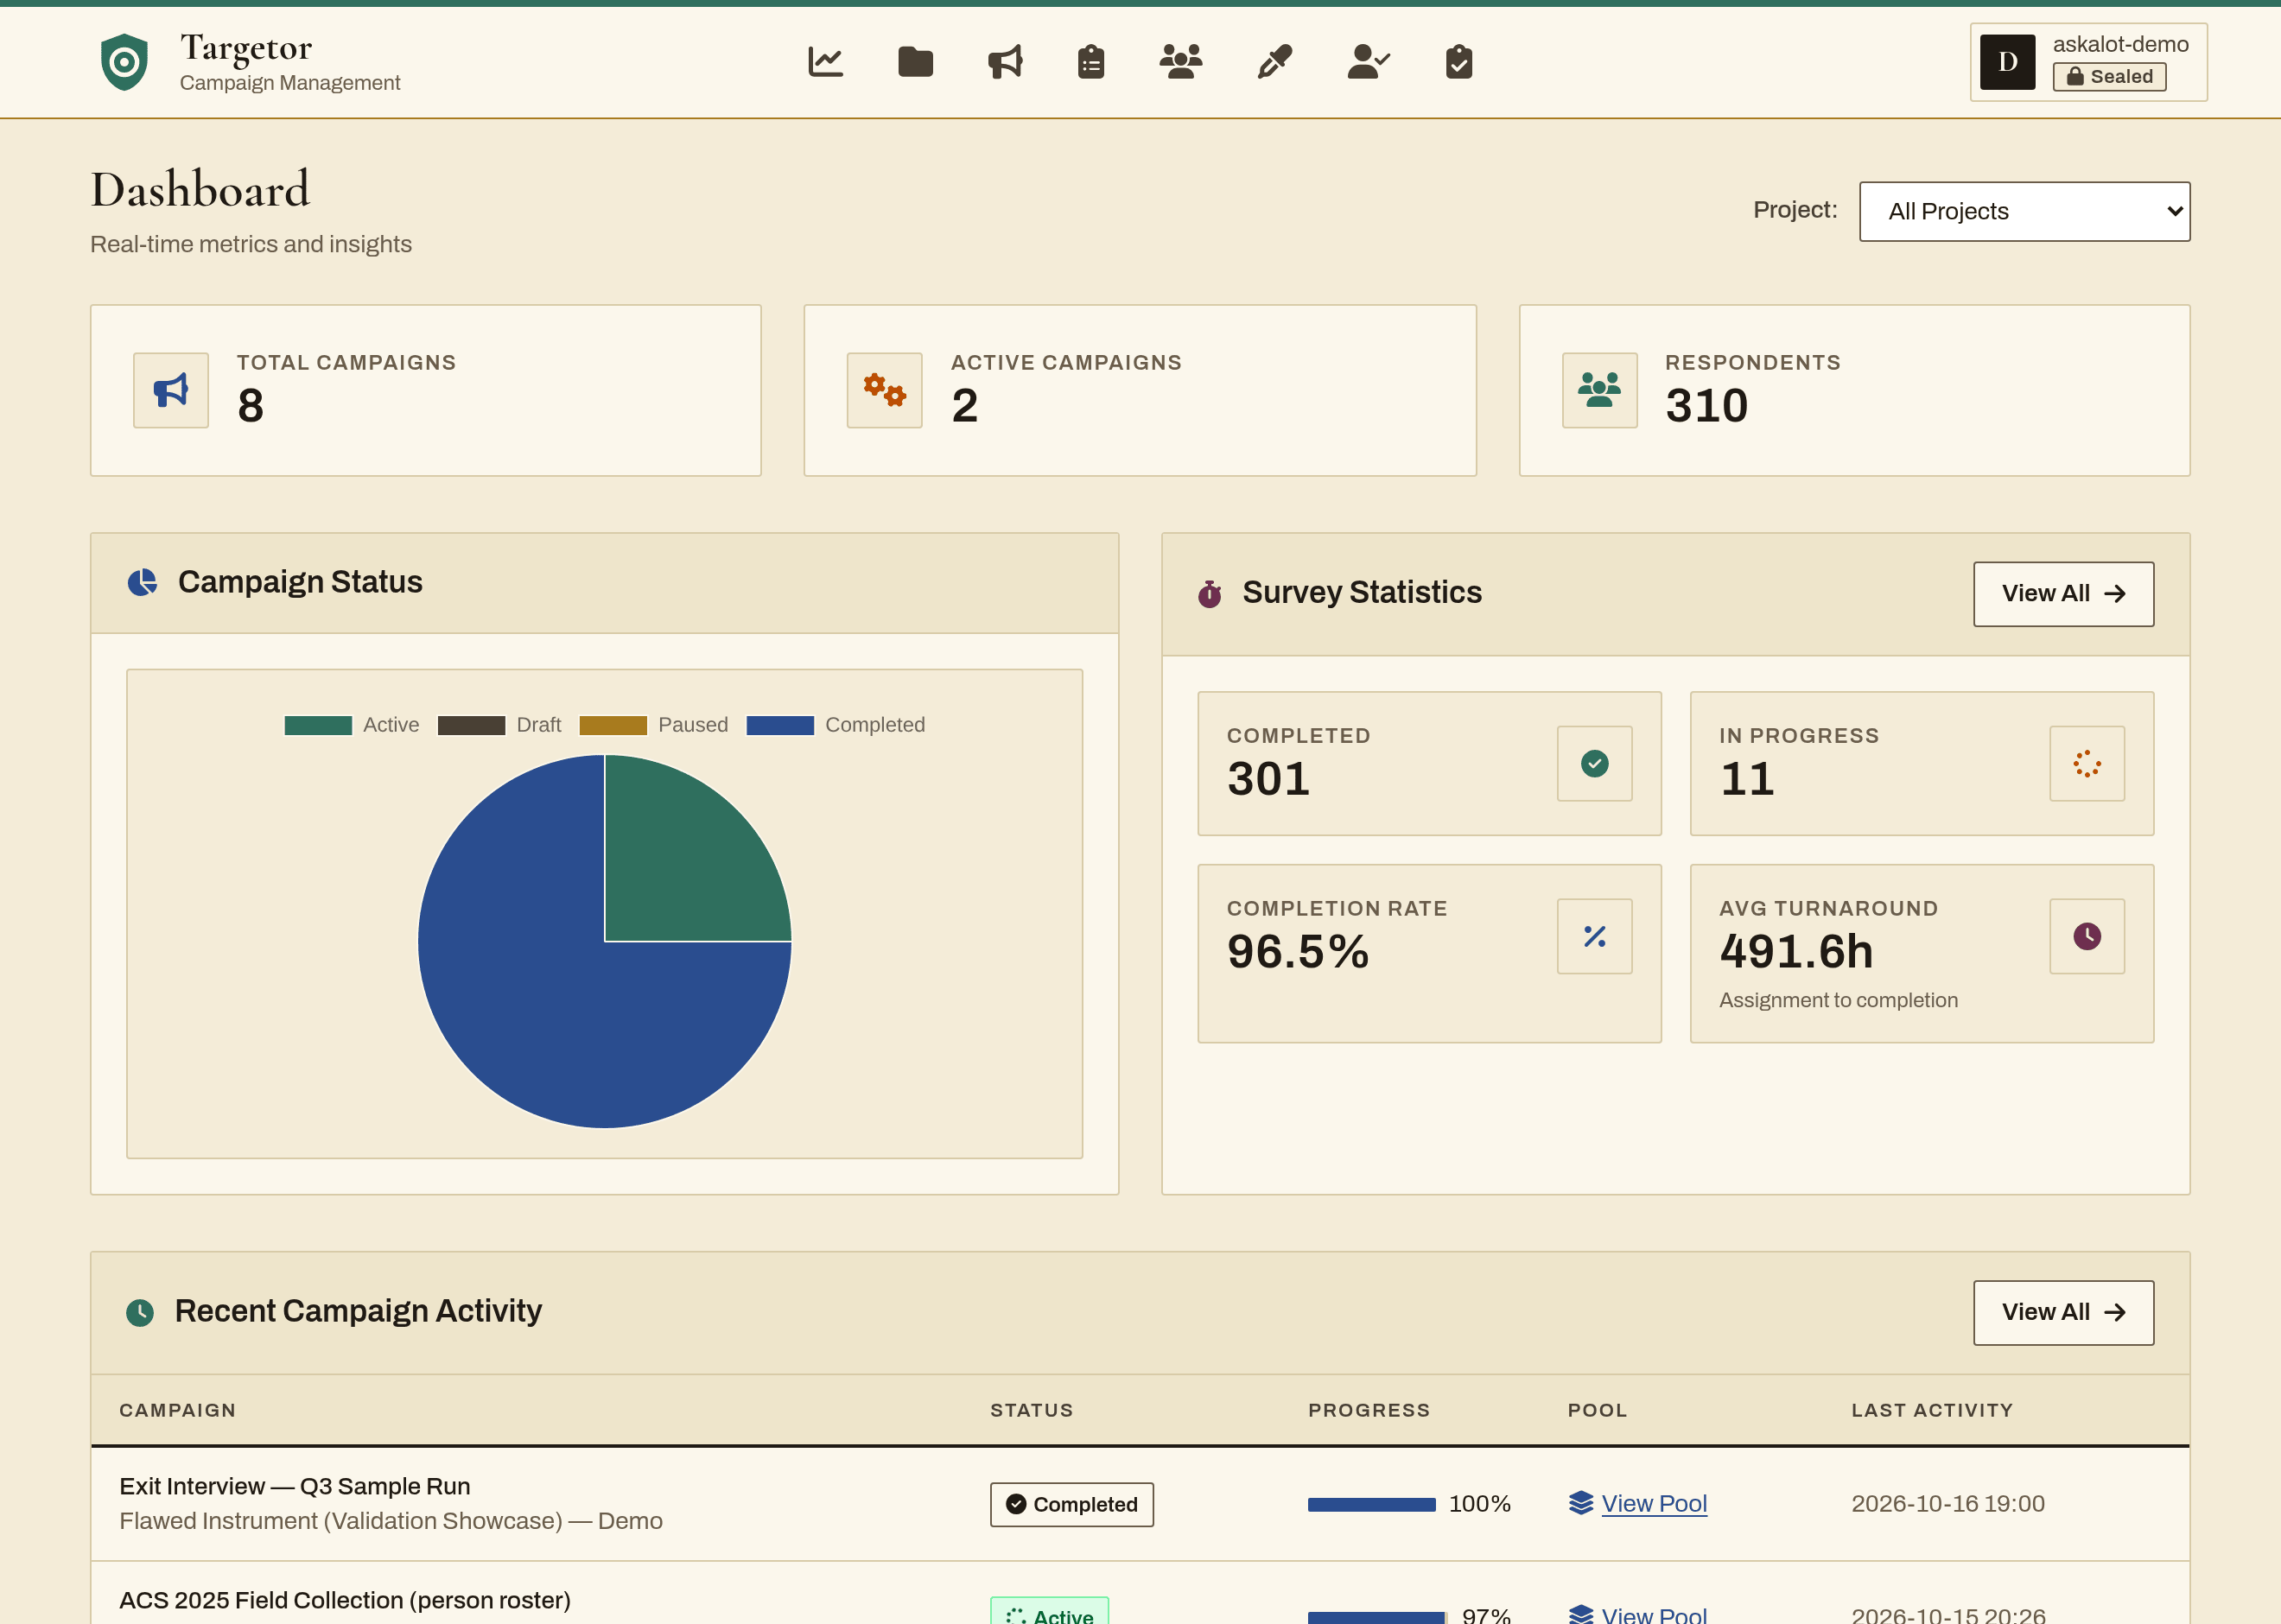
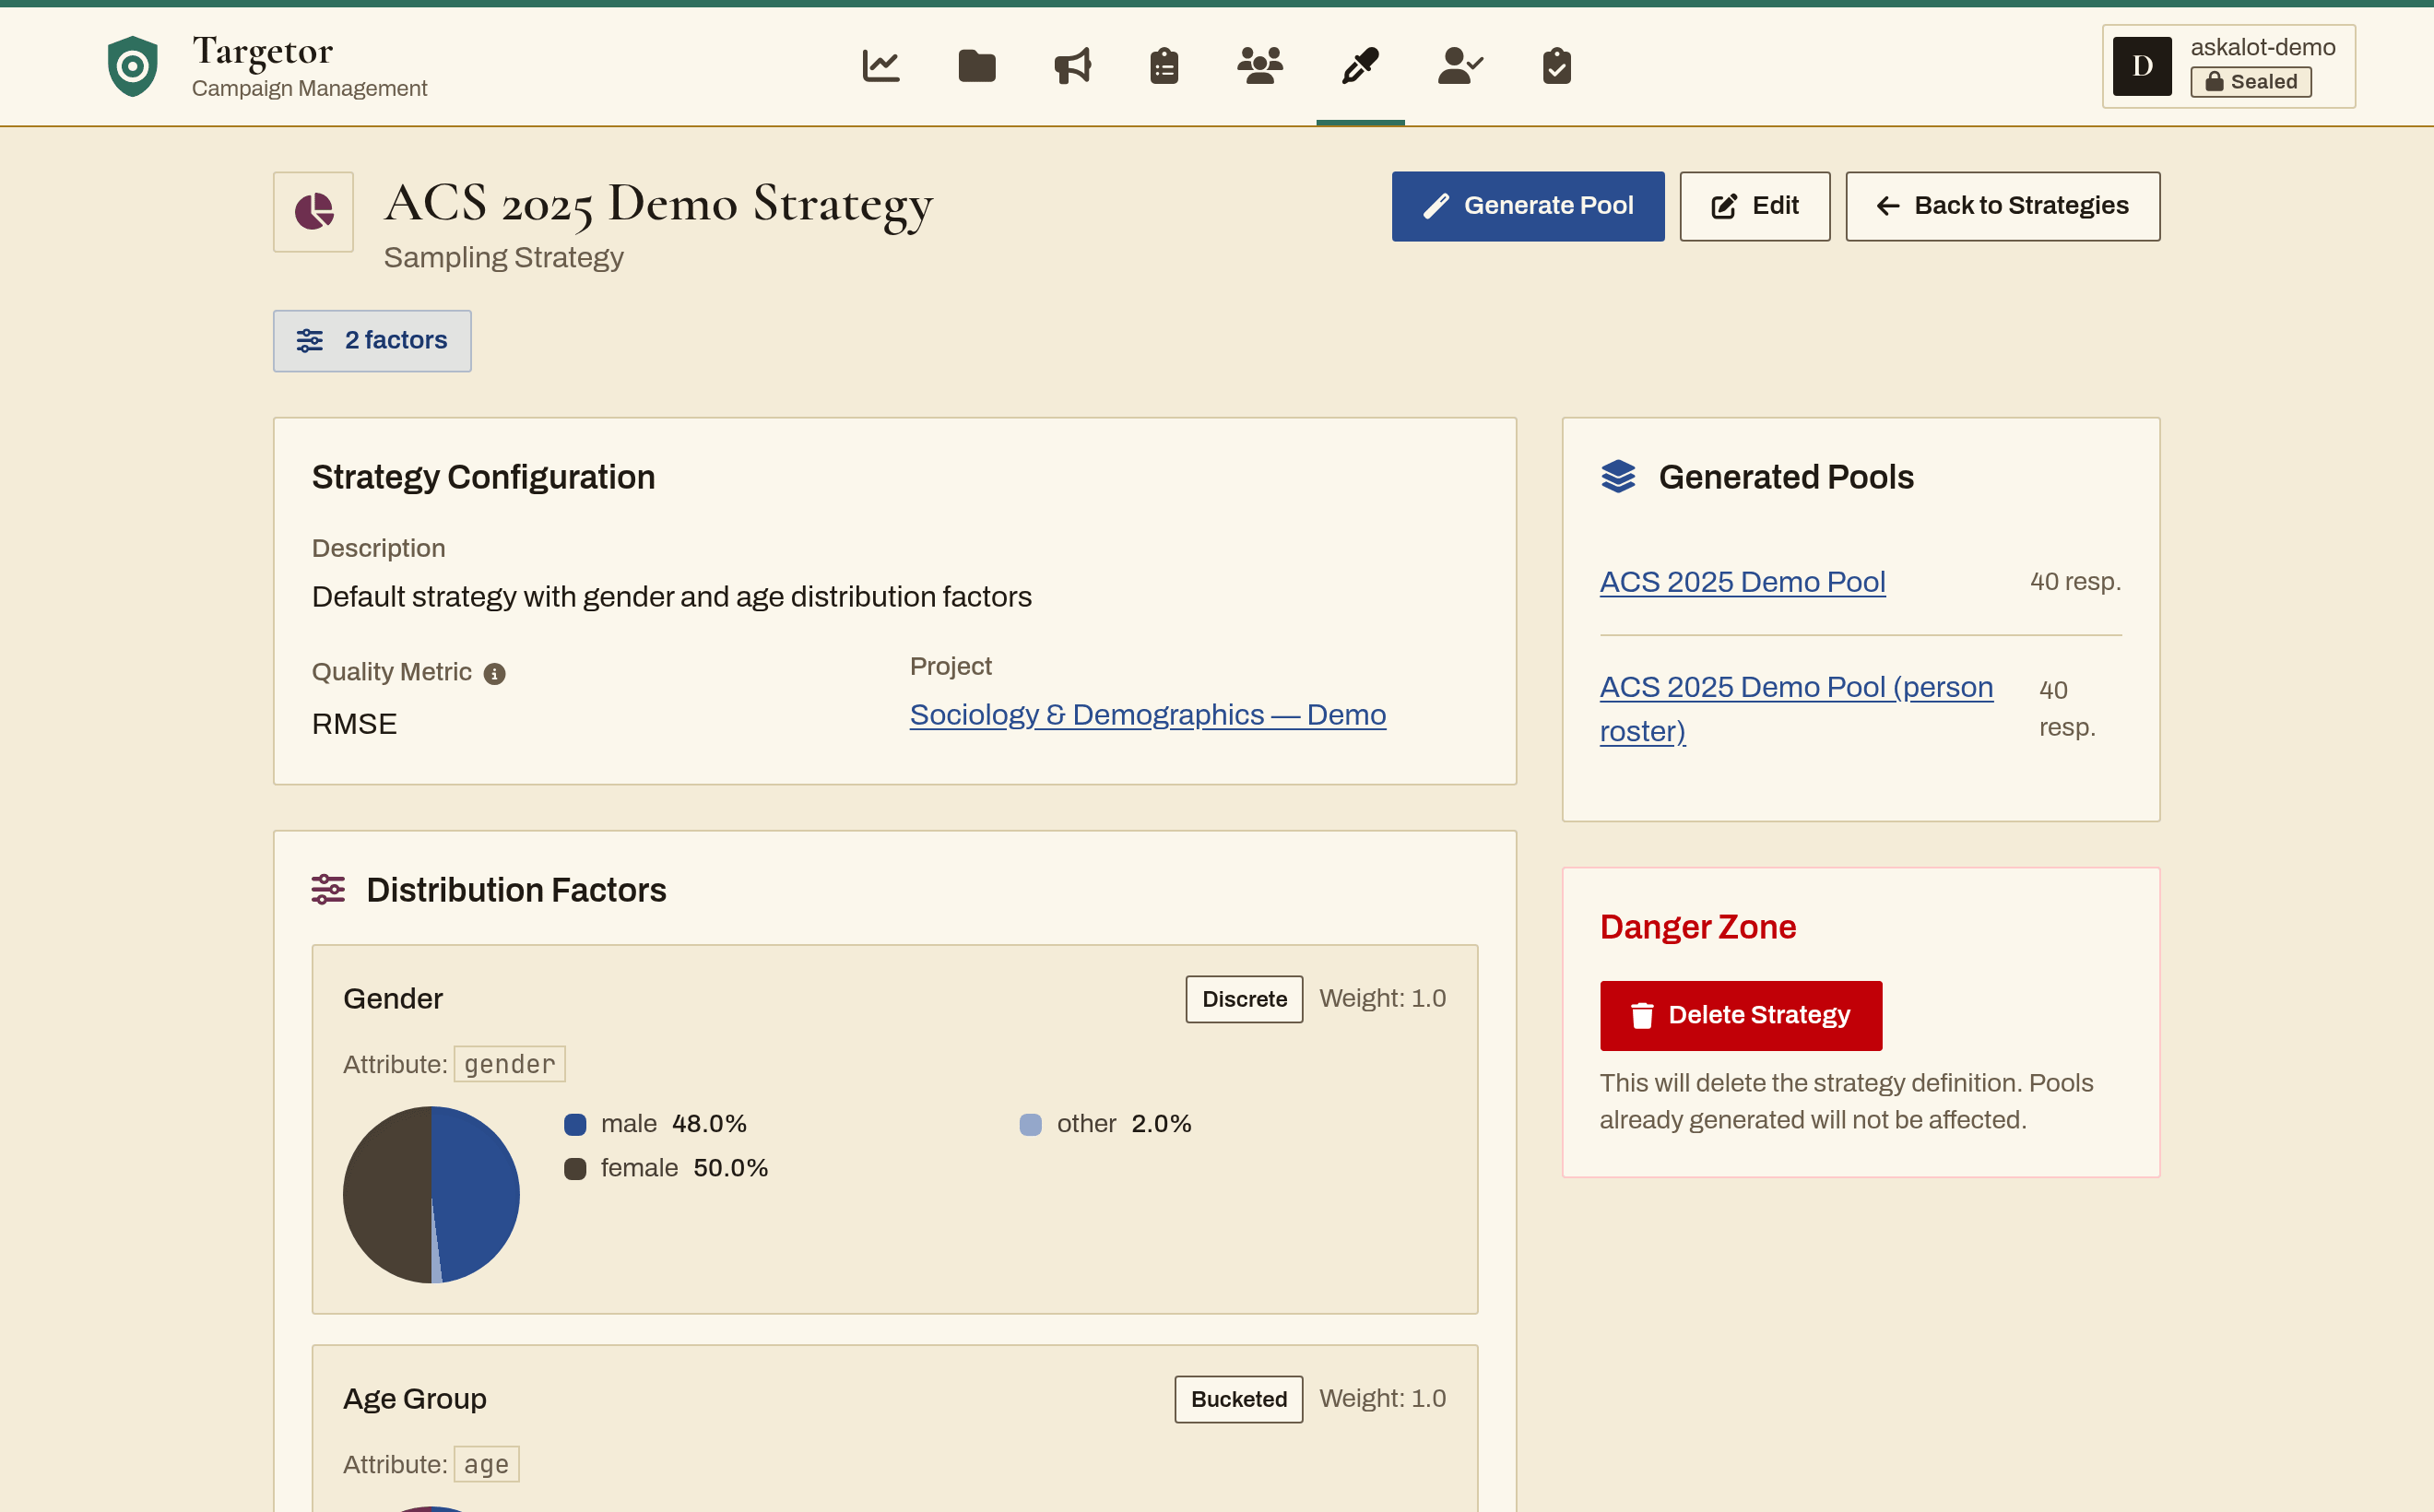
Legen Sie mit dem Agenten Campaign Manager eine Stichprobenstrategie fest, ziehen Sie passende Befragten-Pools und planen Sie die Kampagne als einmaligen Durchlauf oder in wiederkehrenden Wellen. Targetor erzeugt die Umfragen und weist sie Interviewern zu — über einen geführten Assistenten, einen Chat mit dem Agenten oder Ihren eigenen Agenten über MCP.
- Stichprobenstrategien mit demografischen Verteilungsfaktoren
- Befragten-Pools, bewertet anhand der Zielverteilung
- Einladungen, Fortschrittsverfolgung und Interviewer-Auslastung an einem Ort
Der Kampagnenassistent, Schritt für Schritt
- Kampagnendesign — Name, Fragebogen, Modus
- Zielgruppe — Demografie, Stichprobengröße
- Stichprobenstrategie — Schichtungsfaktoren, Verteilungen
- Befragten-Pool — erzeugen und seine Qualität vorab prüfen
- Prüfen & starten — Zusammenfassung, Validierung, Bereitstellung
Pools werden gierig (greedy) oder durch eingeschränkte Zufallsauswahl gezogen und per RMSE gegen das Ziel bewertet. Im Feld verfolgen Sie die Rücklaufquoten aller laufenden Studien, verfeinern eine Kampagne während der Laufzeit und passen Interviewer-Zuweisungen oder Pools an, wie sich das Feld entwickelt — wiederkehrende Wellen erheben weiter nach derselben Strategie.
SirWay
Genau den Fragebogen erheben, der geprüft wurde.
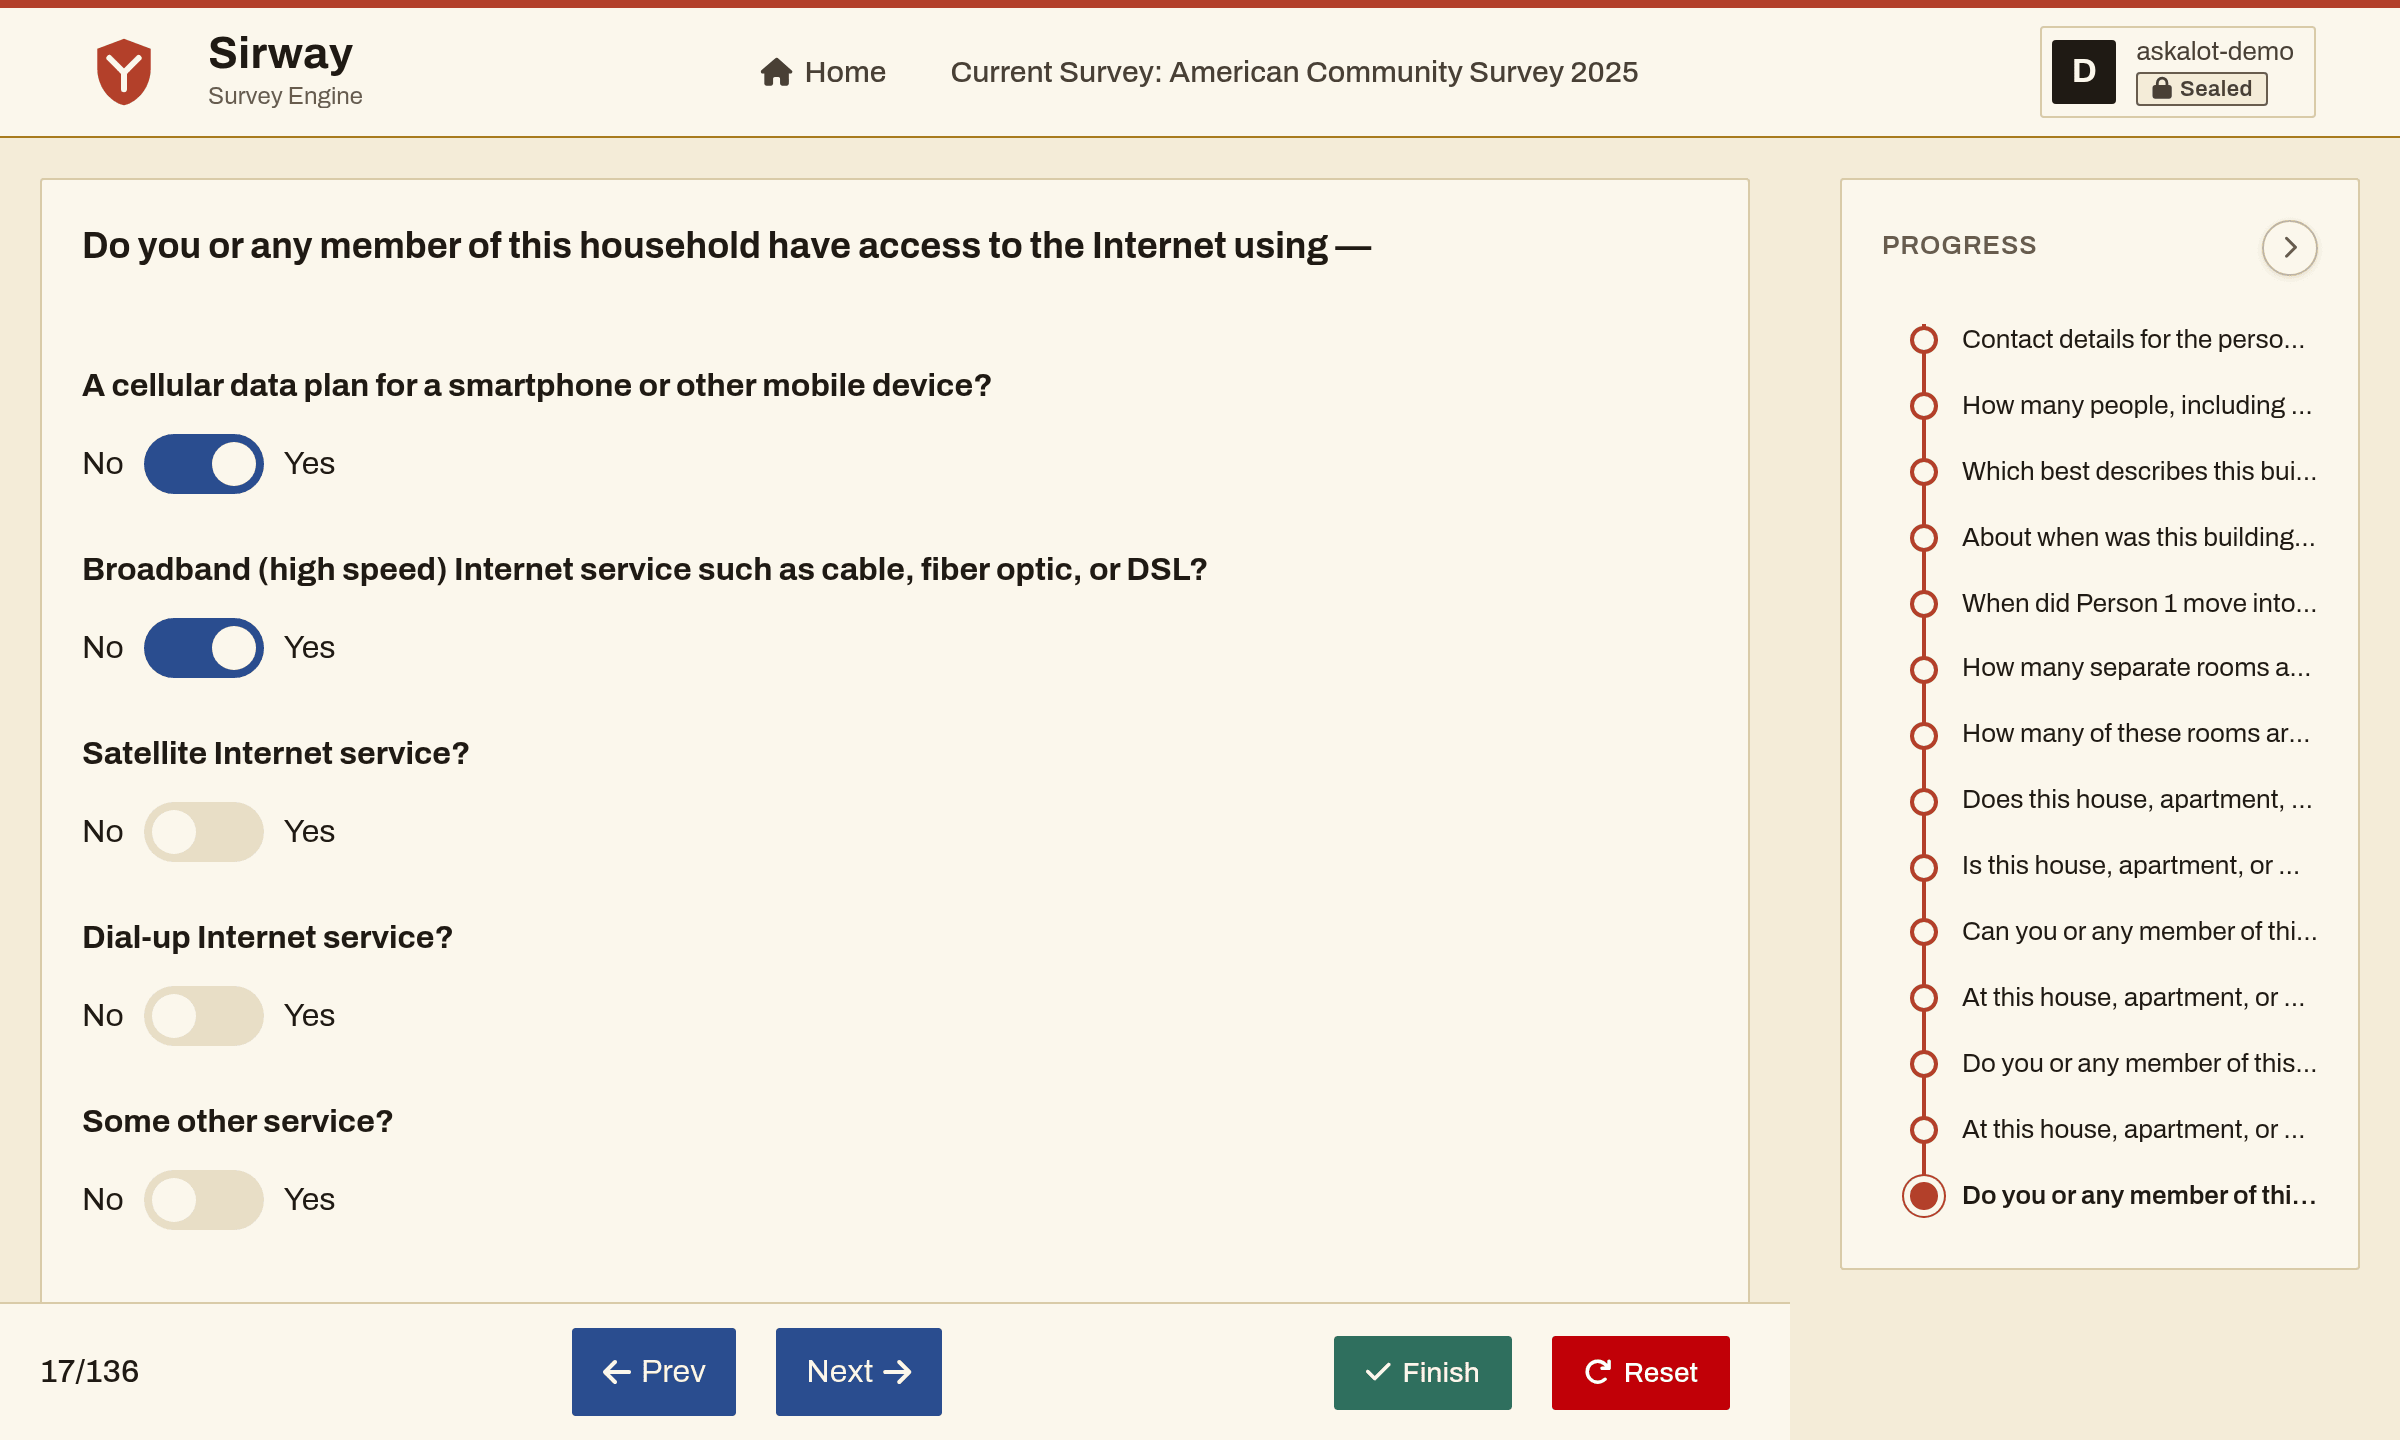
Drei Wege zu antworten: Befragte öffnen einen Link, ein Interviewer führt das Interview telefonisch oder persönlich, oder die befragte Person beantwortet es in ihrem eigenen KI-Assistenten. SirWay ermittelt jede nächste Frage aus den Bedingungen, sodass Befragte nur sehen, was für sie zutrifft — entlang desselben Ablaufs, den der Solver bei der Veröffentlichung des Fragebogens geprüft hat.
- Modi Direkt (Links), Interviewergestützt (telefonisch und persönlich) und KI-gestützt
- Erhebt nur eine Fragebogenversion, die die Veröffentlichungsprüfung bestanden hat
- Zurück-Navigation und Fortschrittsanzeige für Befragte
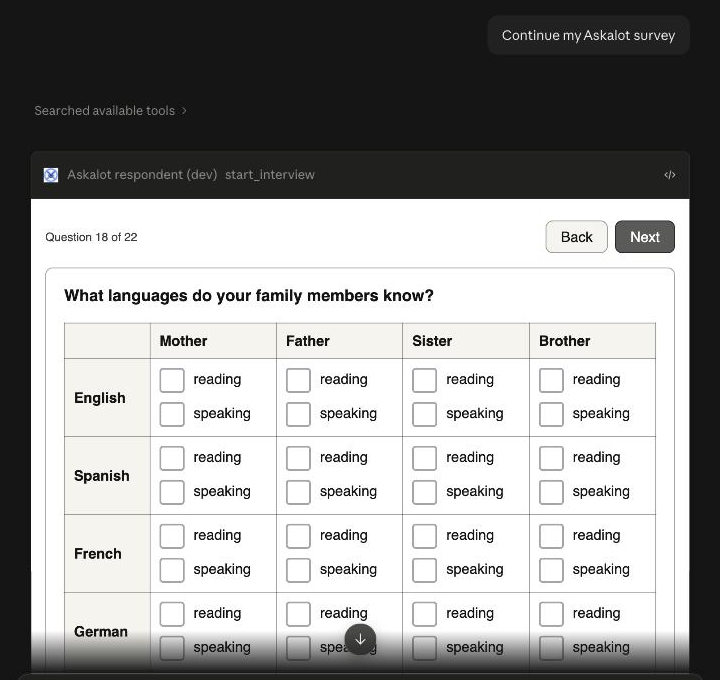
KI-gestützte Interviews
Computergestützte Interviews brachten den Fragebogen auf den Bildschirm des Interviewers. Ein KI-gestütztes Interview bringt ihn in den eigenen KI-Assistenten der befragten Person. Der Assistent übernimmt die Rolle des Interviewers: Er stellt die Umfrage vor und erklärt auf Nachfrage eine Frage. Er antwortet nie — jede Antwort ist der eigene Klick der befragten Person.
Wie der Assistent aus den Antworten herausgehalten wird
- Pro Kampagne angeboten, mit eigenem Einleitungs- und Einwilligungstext der Veranstalter
- Echte Bedienelemente im Chat, gesteuert vom selben verifizierten Ablauf wie die Webumfrage
- Der Assistent kann keine Antwort erfassen, ändern oder überspringen
- Abschlüsse werden nach Modus ausgewiesen, sodass sich Kanäle vergleichen lassen
Balansor
Ergebnisse nicht nur exportieren. Sondern vertreten.
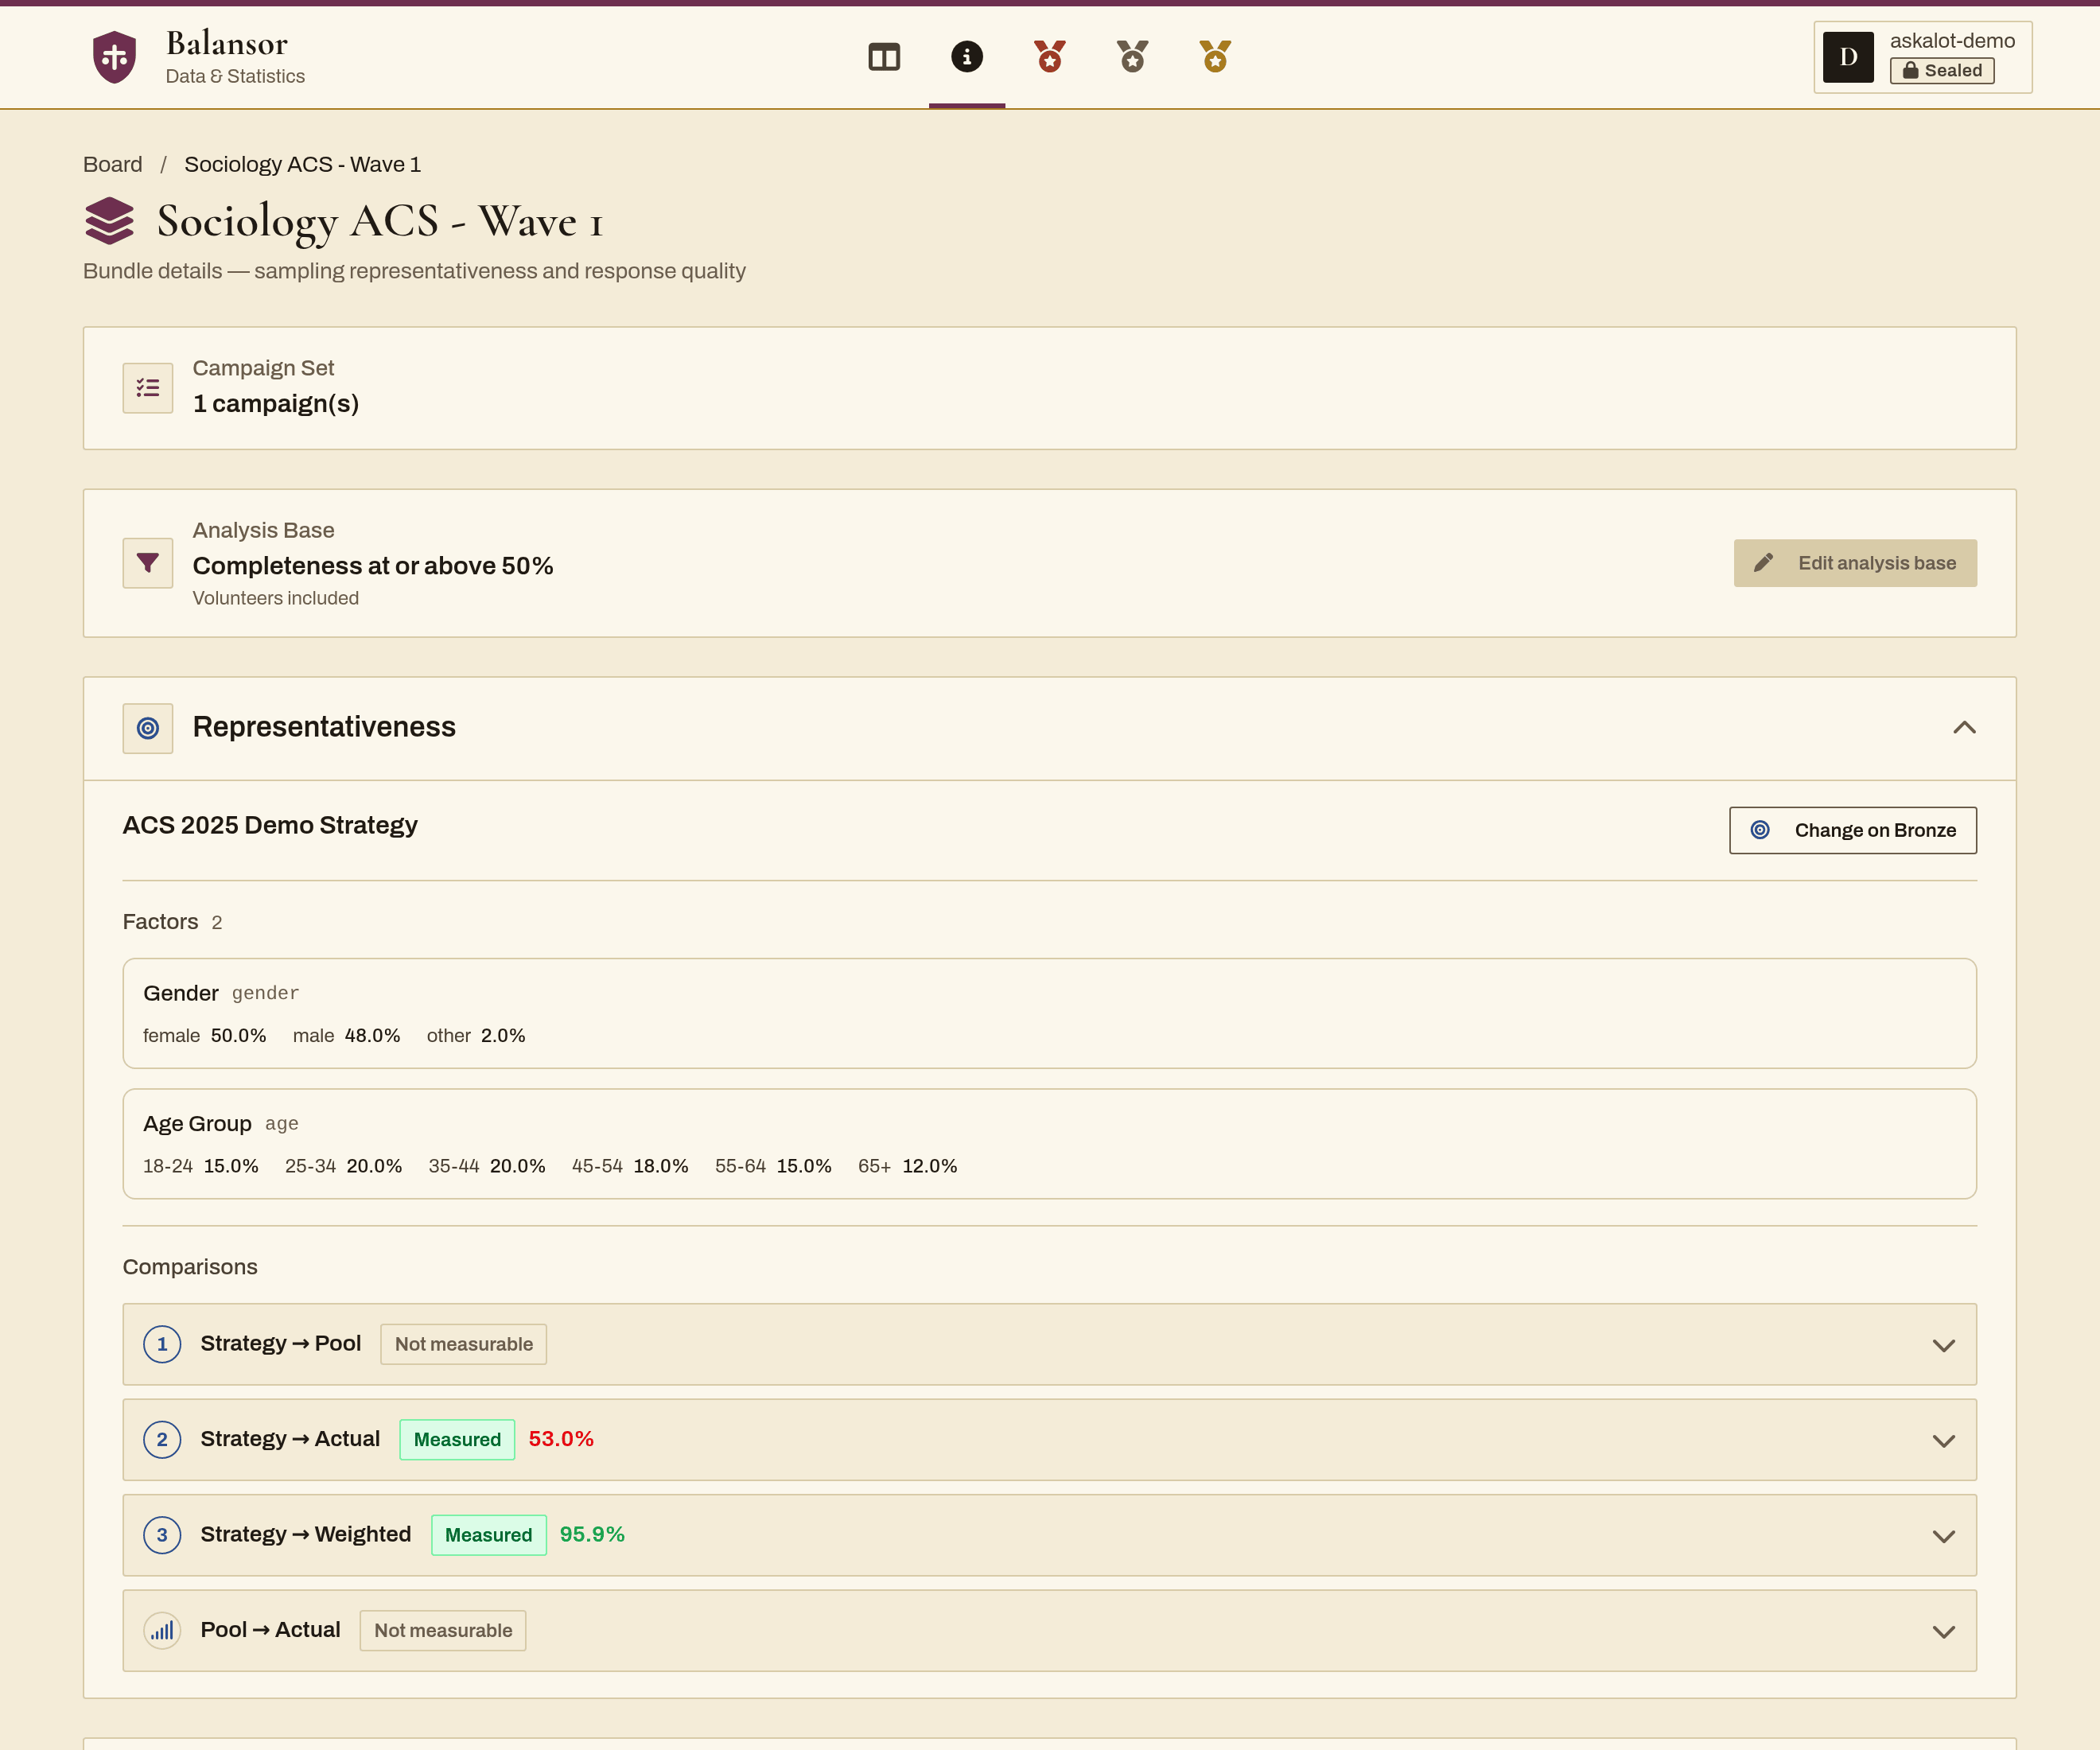
Extrahieren Sie die Antworten, prüfen Sie ihre Qualität und gewichten Sie sie dann per Raking auf die Zielwerte der Stichprobenstrategie. Jede Stufe weist aus, wie repräsentativ, vollständig und konsistent die Daten sind. Der Analyst-Agent liest den Forschungsbericht, interpretiert die Ergebnisse an den ursprünglichen Zielen statt isoliert und schreibt sein Ergebnis als Studie in den Forschungsbericht zurück.
- Raking zur Nachschichtung, mit nachvollziehbarer Herkunft von den Rohantworten bis zum gewichteten Datensatz
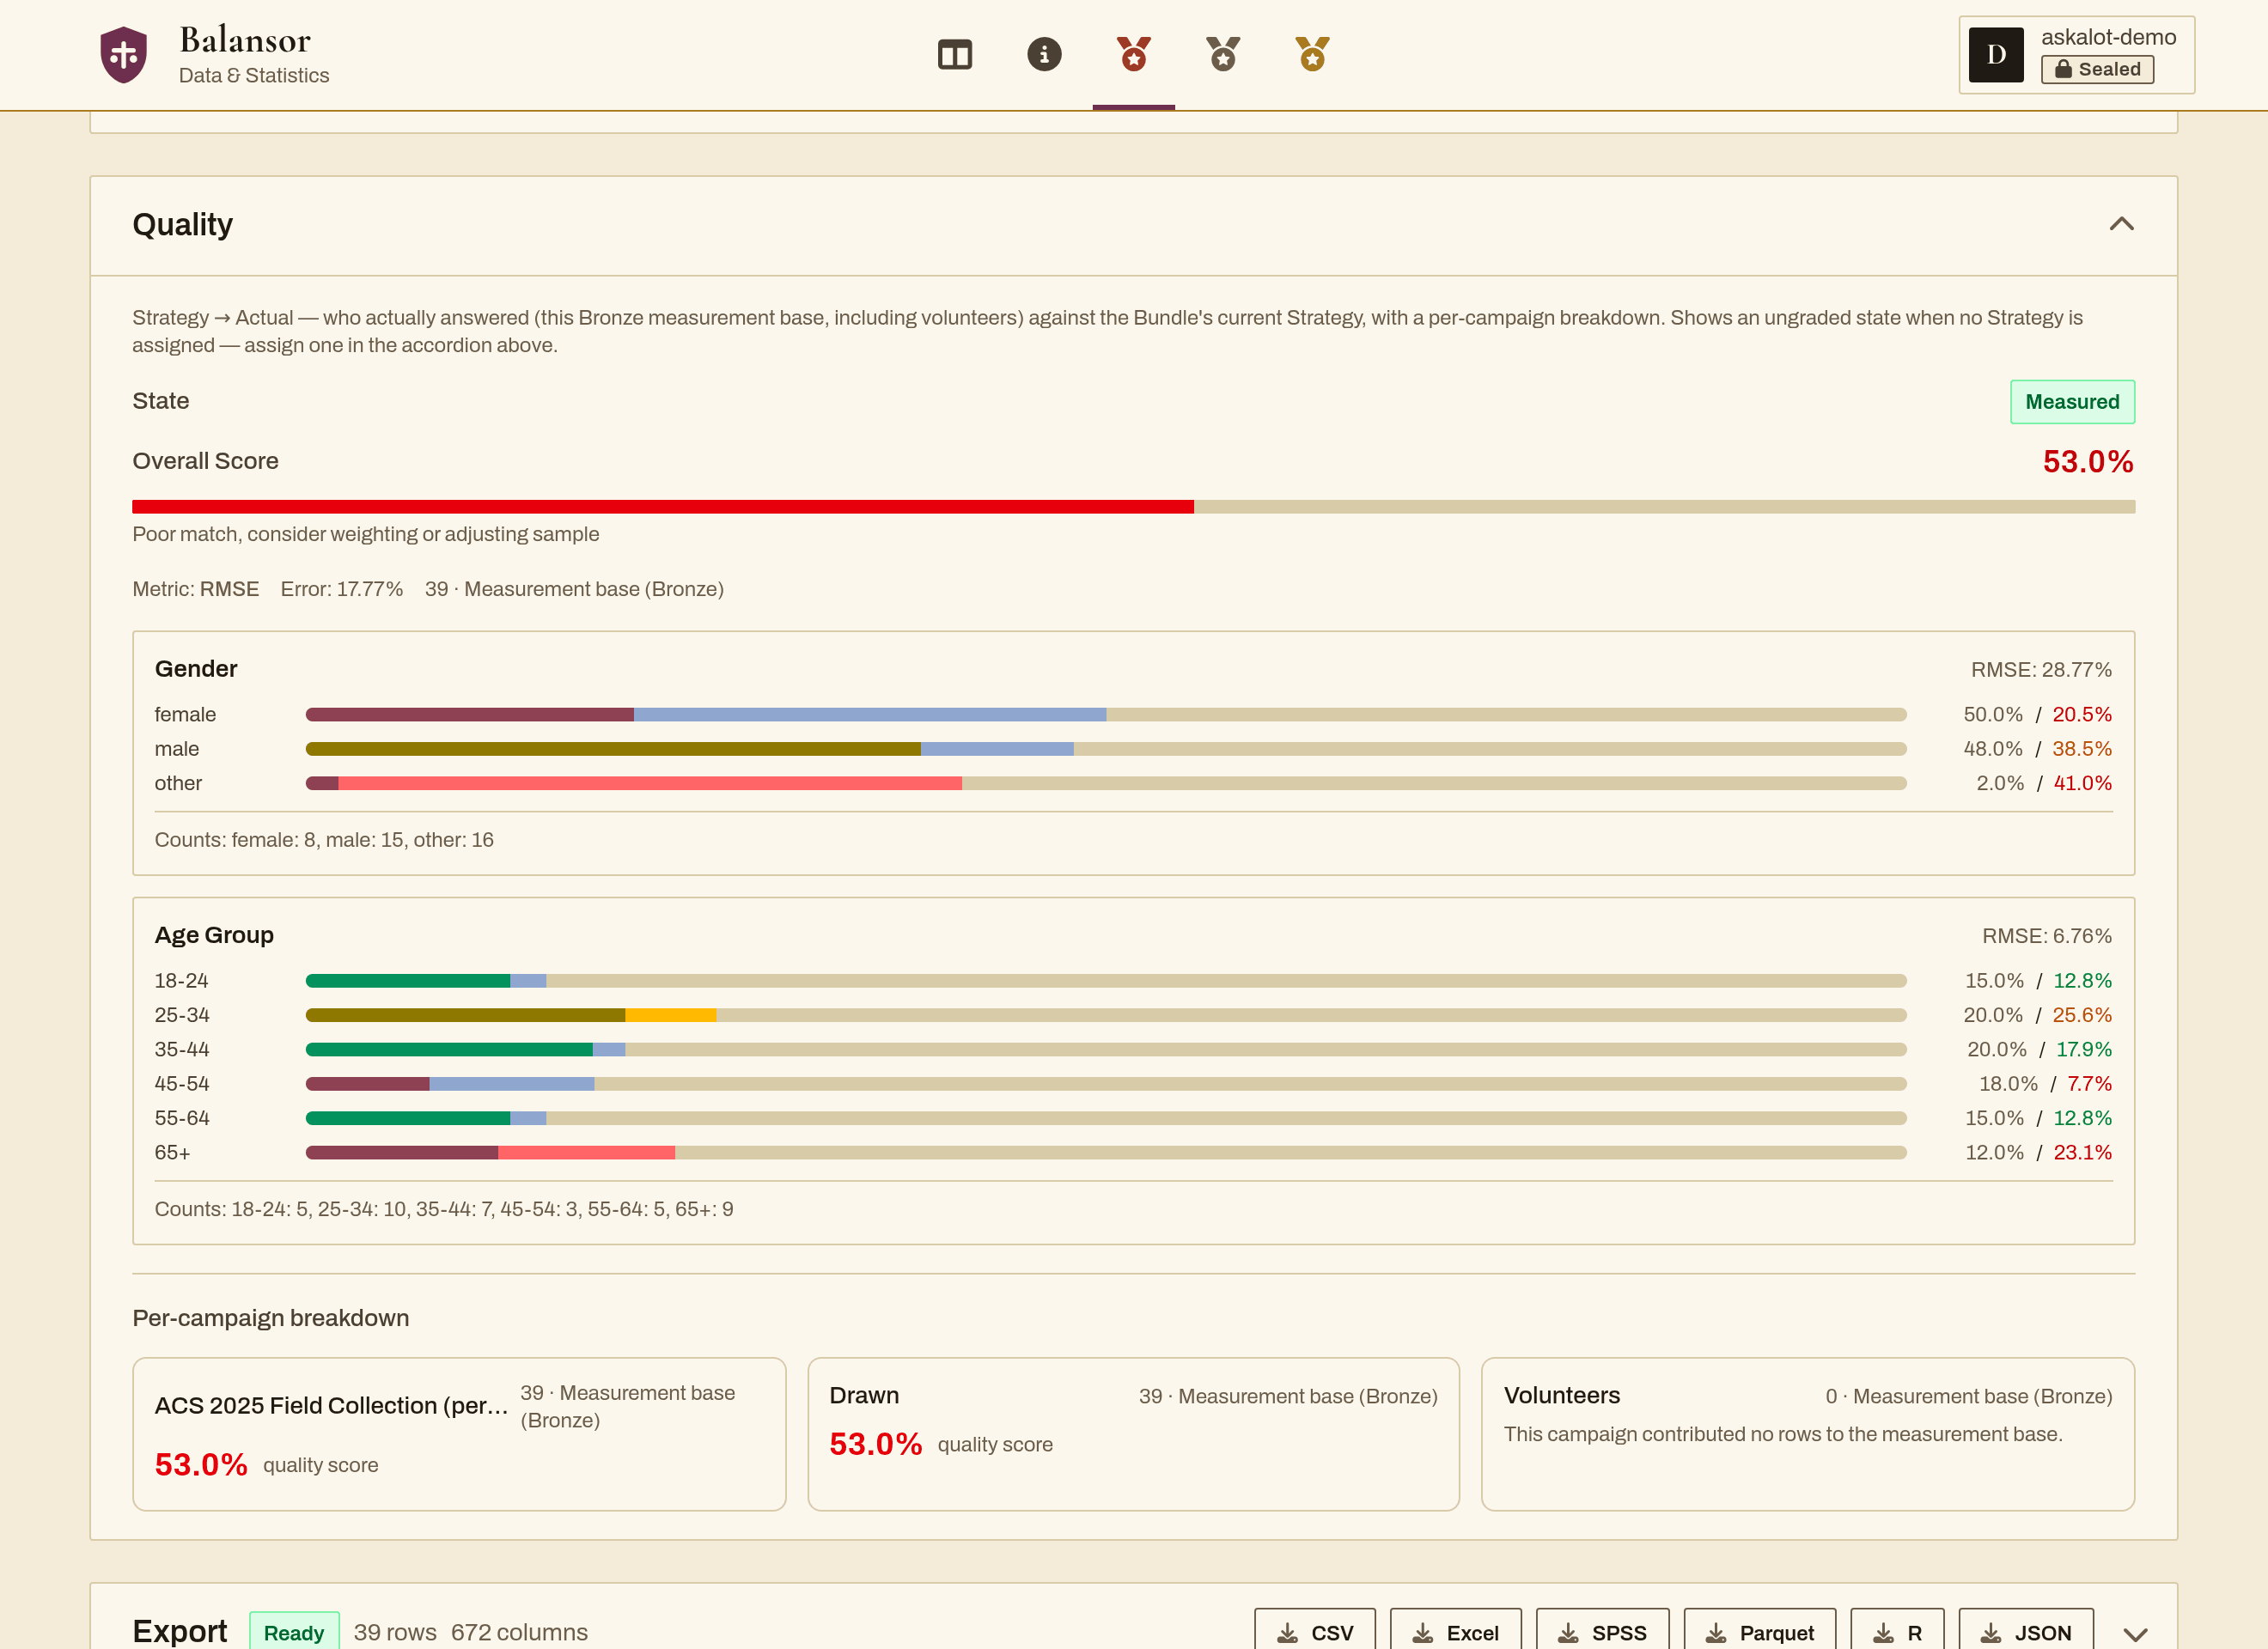
- Repräsentativität, Vollständigkeit, Markierungen für Straightlining und Schnellantworter, Reliabilität, Designeffekt
- Export nach CSV, Excel (.xlsx), SPSS (.sav) und Parquet
Die Datensatz-Pipeline und die Kennzahlen
Die Daten durchlaufen drei Stufen: Bronze (die extrahierten Rohantworten), Silver (qualitätsgeprüft und gewichtet) und Gold (veröffentlichungsreif, mit abgeleiteten Indikatoren), jede mit eigenem Qualitätsbericht.
Repräsentativität wird als RMSE, χ² und maximale Abweichung von den Zielwerten gemessen; die interne Konsistenz als Cronbachs α; die Kosten der Gewichtung als Designeffekt und effektive Stichprobengröße.
Offene Antworten werden nach Bedeutung gruppiert, nicht nach Schlüsselwörtern, sodass ähnliche Gedanken auch bei unterschiedlicher Formulierung zusammenfinden. Benennen Sie die Themen schnell mit c-TF-IDF-Schlüsselwörtern oder mit LLM-Bezeichnungen für natürliche Namen — jedes Thema wird zu einer Gold-Indikatorspalte, bereit für Kreuztabellen und Export. Leitfaden zur Datenanalyse (Englisch)
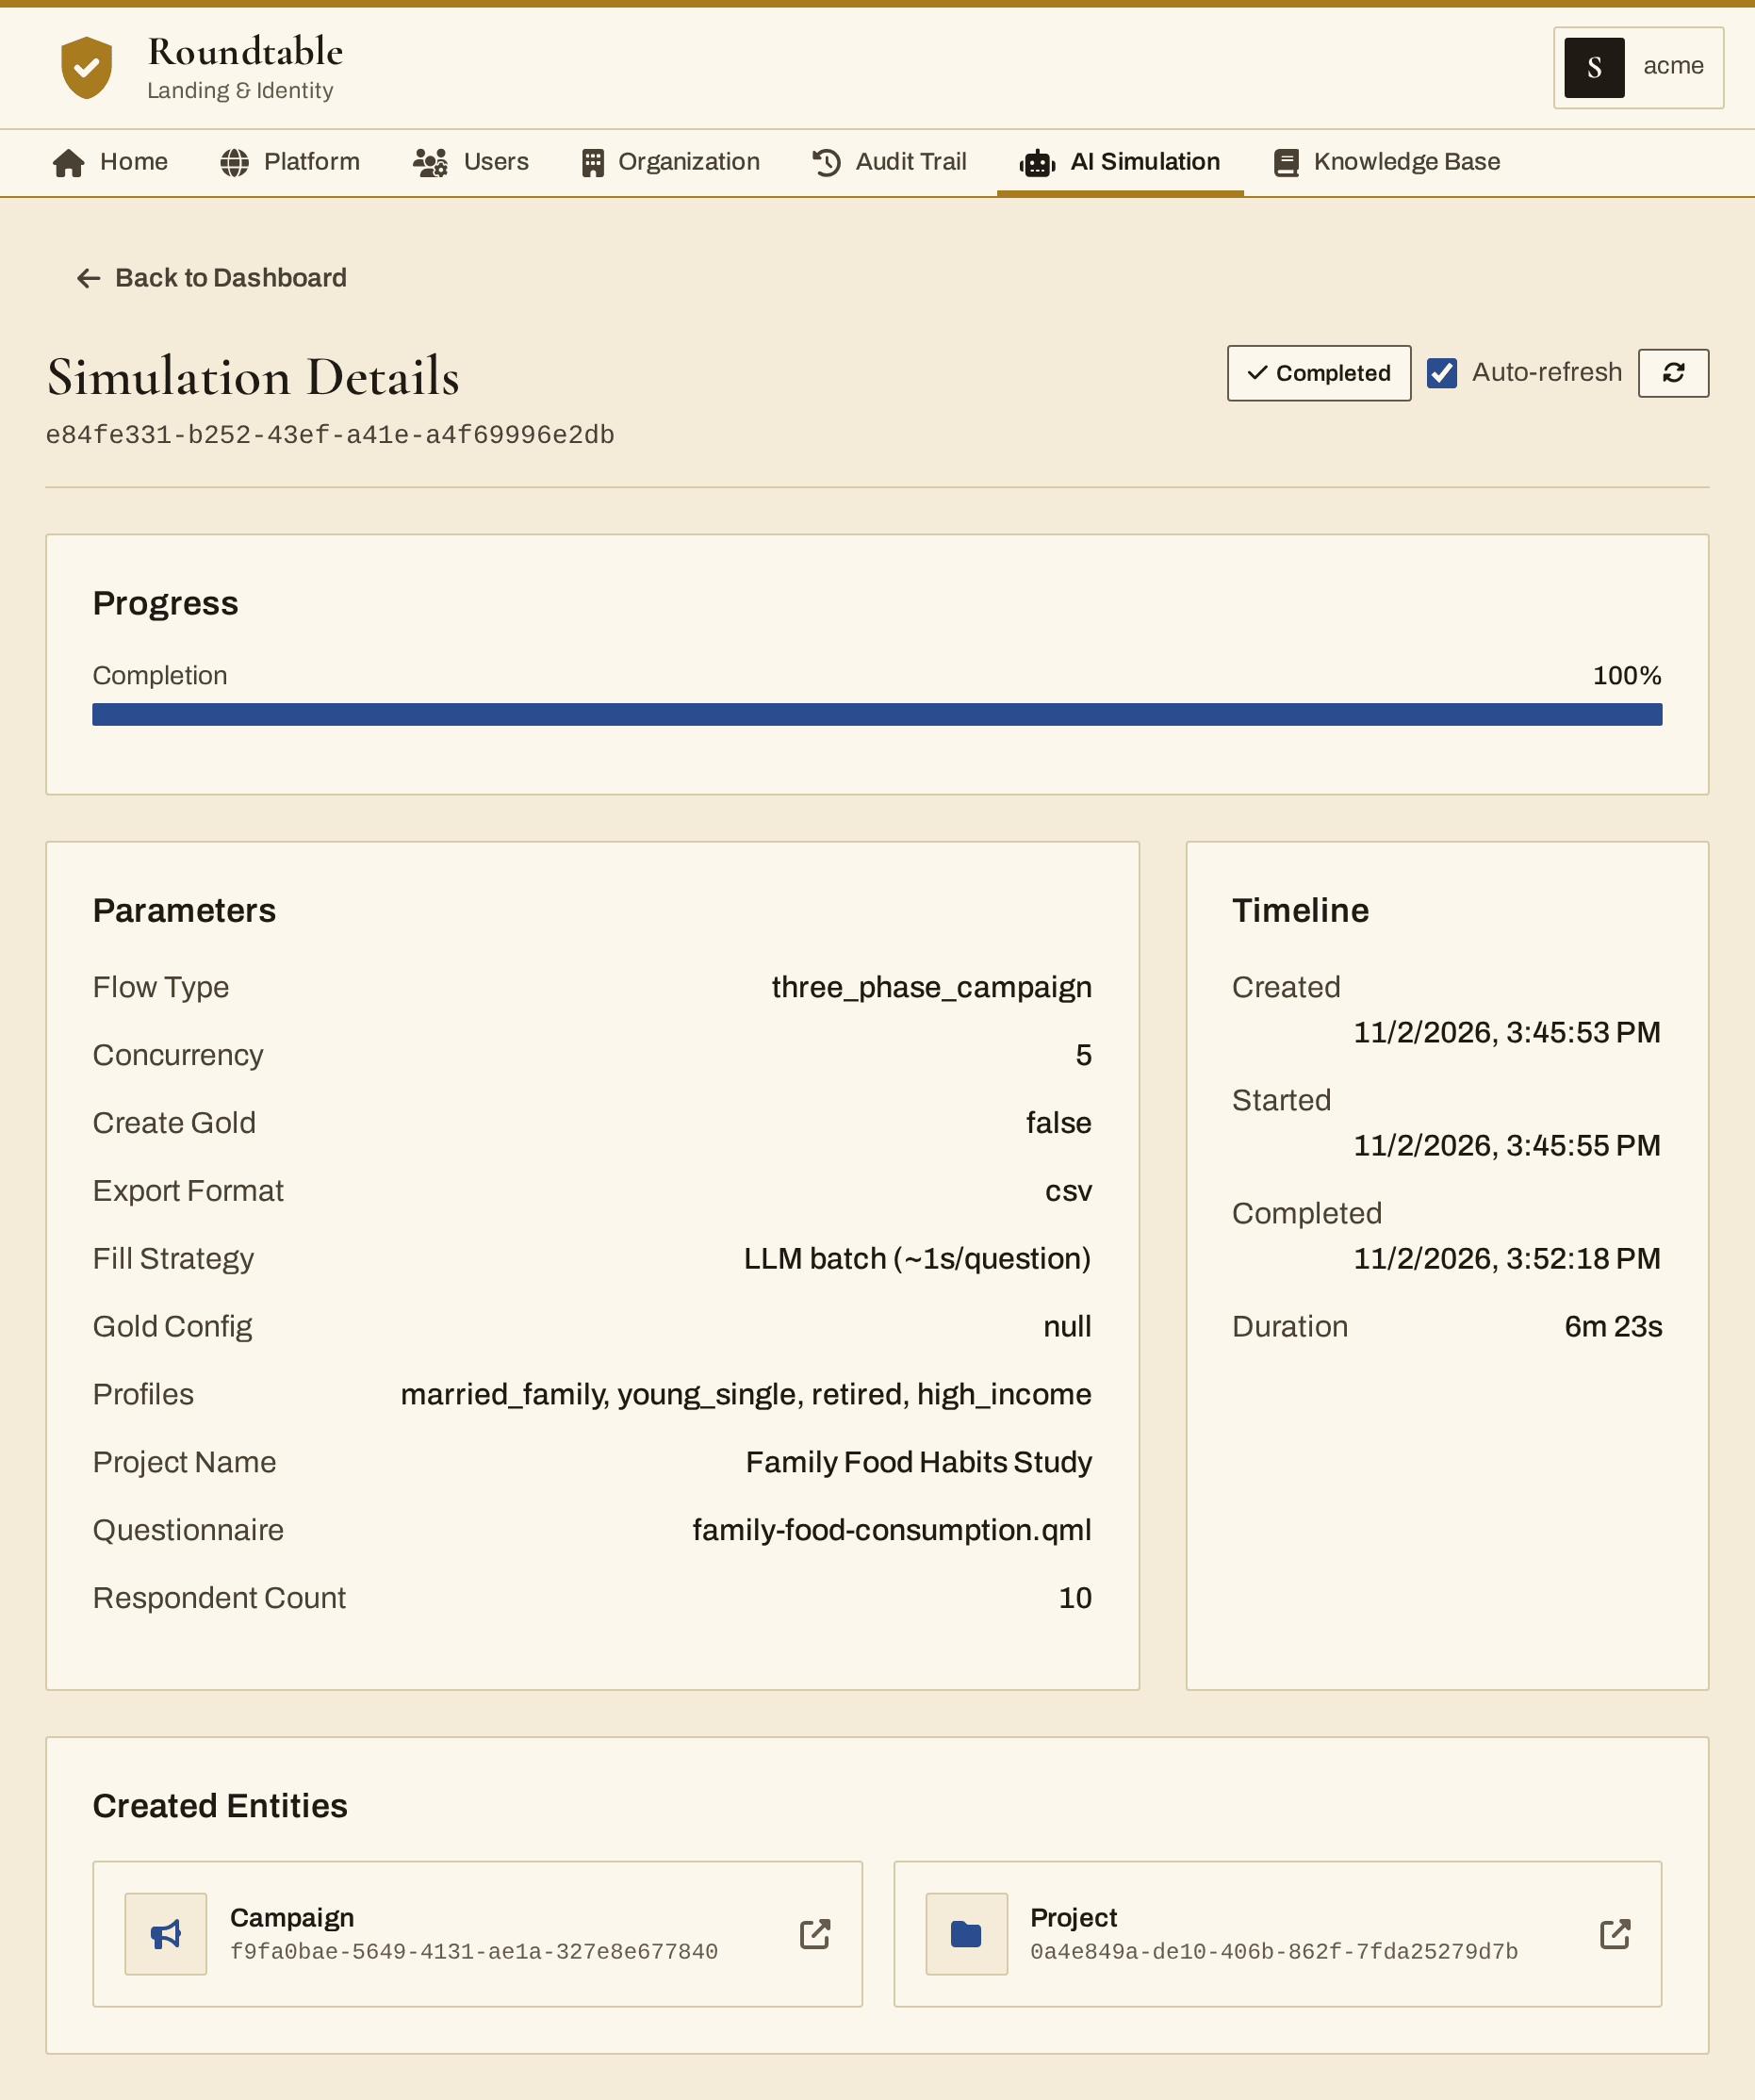
Roundtable
Das ganze Projekt auf die Probe stellen, bevor ein einziger Mensch antwortet.
Führen Sie das Projekt mit synthetischen Befragten durch, um den Ablauf des Fragebogens zu durchlaufen, die Auswertung zu erproben oder einen Demo-Datensatz zu erstellen. Die Befüllungen reichen von schnellen statistischen bis zu Persona-Befragten, die Frage für Frage mit ihrer eigenen Vorgeschichte antworten — damit jemand, der „arbeitslos“ angegeben hat, später keinen Arbeitsplatz beschreibt.
Simulationsmodi und Personas
- Einzeln — eine Umfrage, eine Persona
- Kampagne — der vollständige Ablauf: Vorbereitung, Durchführung, Auswertung
- Massenbefüllung — synthetische Daten in großer Menge
Im aufwendigsten Modus ist jede befragte Person eine eigene Persona, und ein Claude-Modell antwortet Frage für Frage mit der Persona, ihren demografischen Merkmalen und den bisherigen Antworten. Die simulierte befragte Person sieht den Forschungsbericht nie und kann daher nicht auf das hin antworten, was die Forschenden zu finden hoffen.
Portor · REST & MCP
Den gesamten Lebenszyklus aus Ihrem eigenen Agenten steuern.
Jede Funktion ist ein REST-Endpunkt und eines von über 80 Model-Context-Protocol-Tools. Verbinden Sie Askalot mit Claude Code, Cursor, Claude Desktop oder Ihrem eigenen Framework, mit dem Modell Ihrer Wahl — der Agent betreibt die Forschung, und der Fragebogen, den er ins Feld bringt, muss trotzdem dieselbe Verifikation bestehen.
Gehostete Agenten, das Plugin und die Tool-Gruppen
Askalots eigene Agenten Designer, Manager, Analyst und Respondent laufen gehostet, abgestimmt mit dem Claude Agent SDK auf der Anthropic API oder AWS Bedrock mit Ihren Zugangsdaten. Die MCP-Tools funktionieren mit jedem Agenten und jedem Modell.
Installieren Sie das offene Askalot-Plugin für Claude Code — Agenten, Skills, Slash-Befehle und die MCP-Tools. Integrationen (Englisch)
// An agent creates a campaign over MCP
create_campaign({
  name: "Q1 National Survey",
  project_id: "proj_abc123",
  questionnaire_id: "qst_def456"
})

// then draws a representative sample
generate_pool_from_strategy({
  strategy_id: "str_ghi789",
  pool_name: "National Sample Q1",
  requested_size: 1000
})
Gebaut für Forschungsorganisationen, die Strenge verlangen
Dediziert & On-Premises
Eine Single-Tenant-Organisation mit eigener Domain, Datenbank und eigenen Ressourcen, in jeder Cloud oder in Ihren eigenen Räumlichkeiten.
DSGVO
Audit-Trails, Kontrollen der Datenverarbeitung und Verwaltung der Einwilligungen von Befragten in jedem Arbeitsablauf.
Zugriffskontrolle & Audit-Trail
Die Rollen Admin, Designer, Manager und Interviewer, und jede Aktion wird mit Urheber und Zeitpunkt protokolliert.
Bibliothek zur Umfragemethodik
Agenten ziehen rund 30 Methodenbücher und Fachartikel heran — Dillman, Krosnick, Groves, Tourangeau, Bethlehem — und zitieren die verwendete Passage.
Kostenlos für alle. Per Vertrag, wenn Sie es brauchen.
Askalot OS ist kostenlos nutzbar, wie besehen, ohne Garantien. Wenn Sie jemanden brauchen, der Verantwortung trägt, übernimmt die Askalot Survey & Research Kft. diese Verantwortung per Vertrag.